회사에서 GLib의 GHashTable을 대체하기 위해 해시 테이블을 직접 개발한 적이 있다. 출발점은 성능 경쟁보다 GLib 의존성과 유지보수 부담을 줄이는 것이었다. 기존 호출부는 최대한 유지하면서, 실제로 사용하는 64바이트 키에 맞춘 구현을 만들고자 했다. 그렇게 개발한 것이 SHashTable이다. 내부에서 shash를 사용하는 테이블이라 이 이름을 붙였다.
안타깝게도 이 구현은 최종 채택되지는 않았다. 그래도 기존 API를 어떻게 맞췄는지, 고정 길이 키를 어떻게 처리했는지, 충돌 이후의 탐색을 어떻게 구현하고 측정했는지는 남겨둘 만한 개발 경험이었다. 이 글에서는 그 설계 과정을 설명하고, 실험 그래프로 구현의 특성을 살펴본다.
배경
해시 테이블은 키로 값을 찾는 자료구조다. 키를 숫자로 바꾸고, 그 숫자로 배열에서 탐색을 시작할 위치를 정한다. 하지만 서로 다른 키가 같은 위치를 가리킬 수 있으므로, 시작 위치를 계산하는 것만으로는 테이블이 완성되지 않는다. SipHash는 해시값을 만드는 역할이고, Robin Hood 해싱은 충돌 이후 항목을 배치하는 규칙이다.
SipHash
SipHash는 짧은 입력을 빠르게 처리하도록 설계된, 비밀키를 사용하는 해시 함수 계열이다. 입력 데이터와 별도의 비밀키를 함께 받아 고정 길이 결과를 만든다. 여기서 비밀키는 테이블에 넣을 검색 키와 다른 개념이다. 같은 입력이라도 비밀키 설정이 달라지면 결과가 달라질 수 있다. 이 구조는 공격자가 충돌하는 입력을 의도적으로 대량 생성하는 hash-flooding 공격에 대응하려는 목적으로 설계됐다. SipHash 공식 설명
기본형인 SipHash-2-4는 128비트 비밀키를 사용해 64비트 결과를 만든다. 이름 뒤의 숫자는 입력 블록을 섞는 압축 라운드와 마지막에 상태를 섞는 최종화 라운드의 횟수다. SHashTable에 구현한 SipHash-1-4는 각각 1회와 4회를 사용하는 변형이며, 테이블의 seed[2]가 키 역할을 한다. 아래에서는 이 구현의 분산과 비용을 측정한다. 기본형의 보안 성질을 라운드 수와 출력 폭이 다른 구현에 그대로 적용하지는 않는다. 공식 변형 설명
Robin Hood 해싱
Robin Hood 해싱은 해시 함수가 아니라 개방 주소법의 충돌 처리 방식이다. 개방 주소법은 항목을 테이블 배열 안에 저장하고, 예정한 슬롯이 차 있으면 다른 슬롯을 탐색한다. 이 구현에서 사용하는 선형 탐색은 바로 다음 슬롯부터 차례로 확인하는 방식이다. Robin Hood 규칙은 그 과정에서 원래 위치로부터 더 멀리 밀려난 항목에 현재 자리를 우선 배정한다. 탐색 거리가 일부 항목에 몰리는 것을 완화하려는 접근이다. Robin Hood Hashing 원 논문
예를 들어 들어갈 항목 A는 원래 위치에서 세 칸 이동했고, 현재 슬롯의 항목 B는 한 칸만 이동했다고 하자. 이때 A를 현재 슬롯에 두고 B가 다음 슬롯에서 탐색을 계속하게 한다. SHashTable에서는 이 이동 거리를 PSL로 저장하며, 원래 위치에 있으면 0이다. 즉 SipHash로 시작 위치를 정한 다음, Robin Hood 규칙으로 충돌한 항목들의 자리를 조정하는 구조다.
설계와 구현
기존 코드에서는 g 하나만 s로 바꾸도록
대체 구현을 만들 때 첫 번째 기준은 기존 호출부를 크게 바꾸지 않는 것이었다. 그래서 API는 GHashTable의 형태에 맞춰, 함수 접두사의 g 한 글자만 s로 바꾸도록 설계했다. 예를 들어 기존의 삽입·조회 호출은 다음처럼 대응한다.
g_hash_table_insert(table, key, value);
g_hash_table_lookup(table, key);

s_hash_table_insert(table, key, value);
s_hash_table_lookup(table, key);
자료형은 GHashTable에서 SHashTable로 바뀌지만, 생성 시 해시·동등성 비교 콜백을 전달하고 key/value를 저장하는 사용 방식은 이어가도록 했다. 생성·삽입·교체·조회·삭제뿐 아니라 destroy callback, 참조 관리, 반복자 API도 구현했다. 공개 인터페이스는 shash.h에 두고 내부 구조는 hashtable.h로 분리했다. 공개 헤더의 기본 타입과 콜백 타입도 직접 정의해, 해당 헤더가 GLib를 include하지 않도록 했다.
함수 이름을 맞추는 것과 모든 동작의 호환성을 보장하는 것은 다른 작업이다. 특히 key/value를 누가 소유하는지, 같은 키를 다시 넣으면 무엇을 교체하는지, 순회 중 삭제를 어떻게 처리하는지는 대체 구현에서도 중요하다. SHashTable은 키와 값을 포인터로 보관하고, 해제 여부를 destroy callback으로 결정한다. 여기서 설명하는 것은 이러한 사용 형태를 맞춘 설계이며, GLib 전체 API의 완전한 호환성을 검증했다는 의미는 아니다.
64바이트 키 처리
범용 해시 테이블을 그대로 다시 만드는 대신, 주요 입력인 64바이트 SHA-256 hex 문자열에 맞춘 경로를 두었다. 이미 만들어진 문자열을 키로 사용하는 것이므로 여기서 SHA-256을 새로 계산하지는 않는다. s_logging_hash()는 길이를 64로 고정해 해싱하고, 일반 문자열용 s_str_hash()는 strlen()으로 길이를 구한다. 따라서 주 사용 경로에서는 해시를 계산하기 위해 문자열 길이를 다시 찾을 필요가 없다.
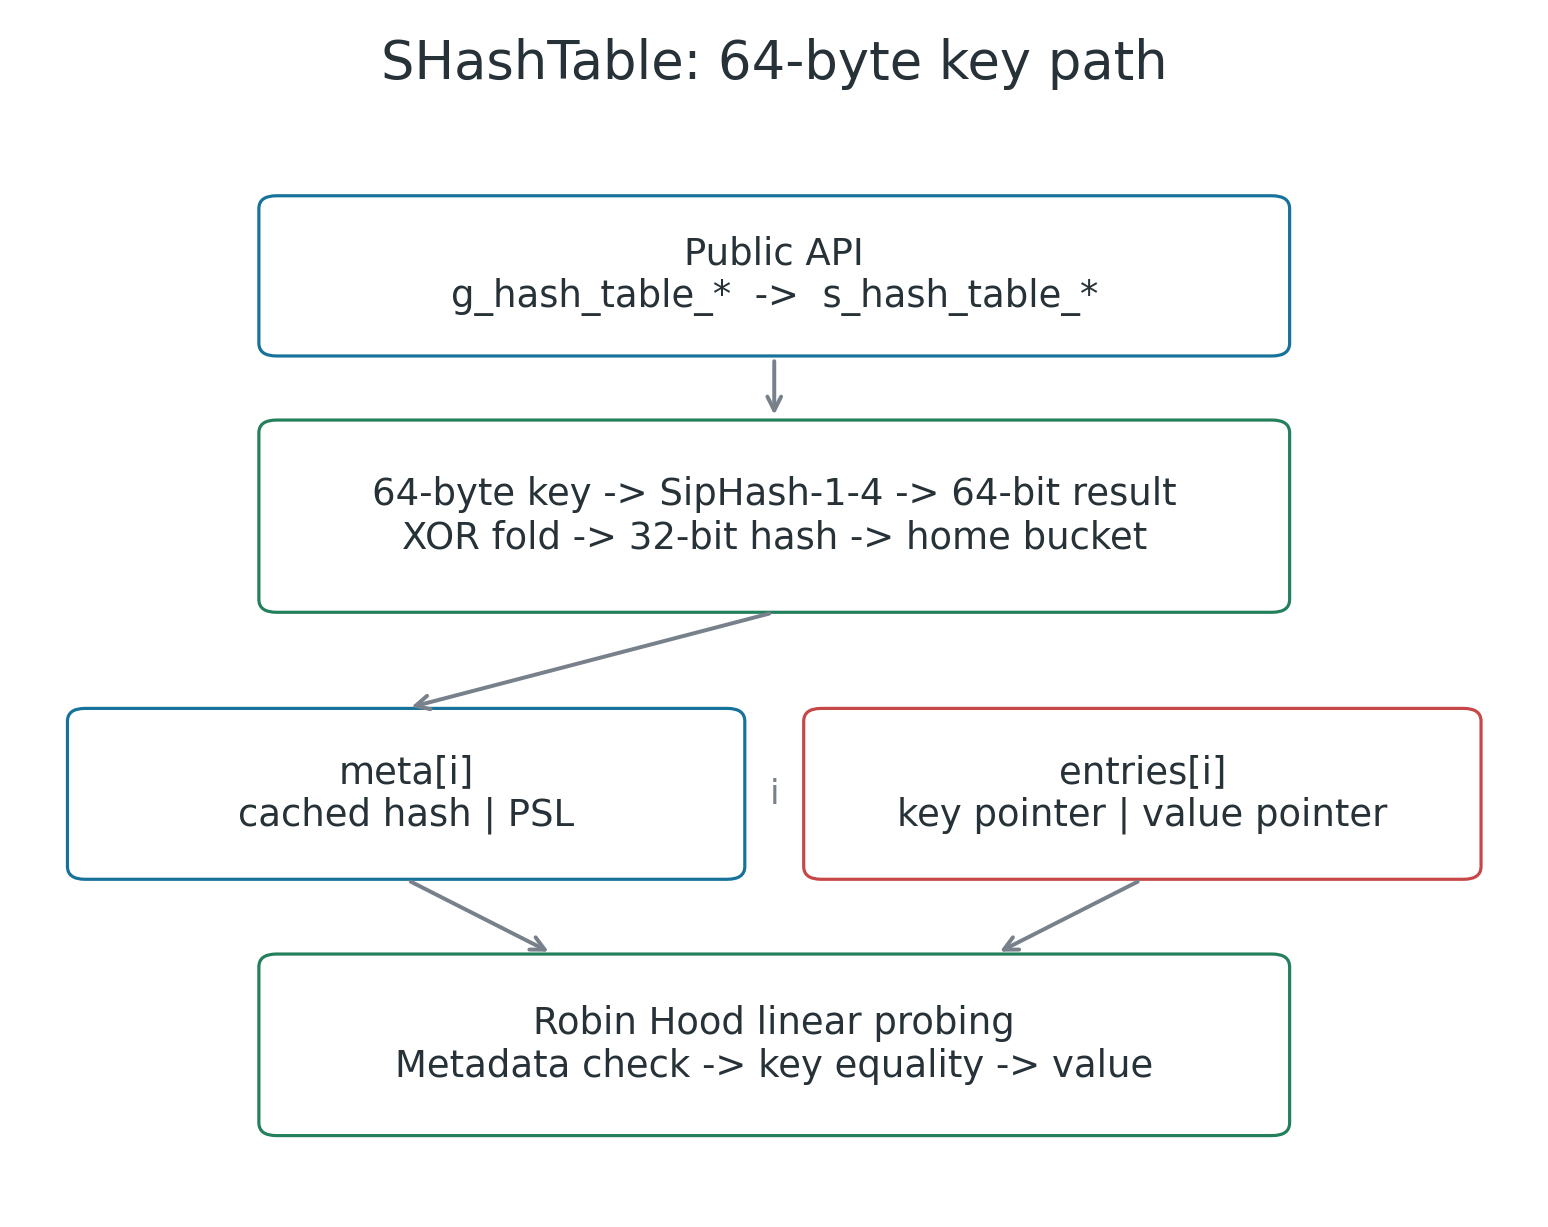 그림 1. SHashTable의 해시 생성과 Robin Hood 탐색 구조
해시 코어에는 SipHash-1-4를 사용했다. 테이블마다 128비트 시드를 두고, 코어가 만든 64비트 결과의 상위·하위 32비트를 XOR해 테이블용 해시값을 얻는다. 빈 슬롯은 해시값 0으로 표시하므로 결과가 0이면 2로 바꾼다. 실제 저장 위치의 출발점은 hash & mask로 계산한다.
고정 길이 처리는 입력 조건을 명확하게 만든다. logging 경로에는 읽을 수 있는 64바이트 버퍼를 전달해야 한다. 또한 입력을 해싱하는 것과 키의 동일성을 확인하는 것은 별개다. 기본 문자열 비교 경로를 사용한다면 문자열 종료 조건도 만족해야 한다. 64바이트 특화라는 이유로 임의의 바이너리 키까지 같은 방식으로 사용할 수 있는 것은 아니다.
메타데이터와 탐색
좋은 해시를 사용해도 같은 위치에서 탐색을 시작하는 키는 생긴다. 그래서 시작 위치를 정하는 해시 함수와 충돌 이후의 배치를 관리하는 테이블 구조를 나누어 설계했다. SHashTable은 선형 탐색을 사용하며, 원래 위치에서 밀려난 거리를 PSL로 기록한다. meta[]에는 해시값과 PSL을, entries[]에는 key/value 포인터를 저장한다. 조회는 메타데이터부터 확인하고 저장된 해시가 일치할 때 실제 키를 비교한다.
앞에서 설명한 Robin Hood 교환은 메타데이터와 key/value 쌍에 함께 적용한다. 이 규칙은 시작 버킷이 같은 키뿐 아니라 서로 다른 시작 위치에서 출발해 탐색 경로가 겹치는 키에도 적용된다.
이 배치 규칙 덕분에 조회는 빈 슬롯을 만났을 때뿐 아니라, 현재 탐색 거리가 저장된 항목의 PSL보다 커졌을 때도 종료할 수 있다. 삭제에서는 뒤 항목을 한 칸씩 당기면서 PSL을 줄이는 backward shift를 사용한다. 삭제 위치를 빈자리로 남겨 두면, 그 뒤로 밀려난 키의 조회가 중간에서 끝날 수 있기 때문이다. 확장·축소 판단 기준은 각각 75%와 25% 점유율이며, 리사이징은 저장된 해시값을 재사용해 재배치한다.
실험 결과
해시의 분산과 충돌
구현한 경로를 평가하려면 해시 자체의 특성과 테이블 동작을 나누어 봐야 했다. 먼저 logging과 string, 직접 호출한 DJB2 계열 legacy 함수, Linux jhash를 비교했다. 여기서 legacy는 GHashTable 전체를 의미하지 않는다. 코드에 남아 있는 s_str_key_hash()의 직접 호출 결과다. 이 함수를 SHashTable 생성자의 콜백으로 전달하면 실제로는 SipHash 기반 s_str_hash()가 선택되므로, 직접 호출 실험과 테이블 사용 경로를 구분했다.
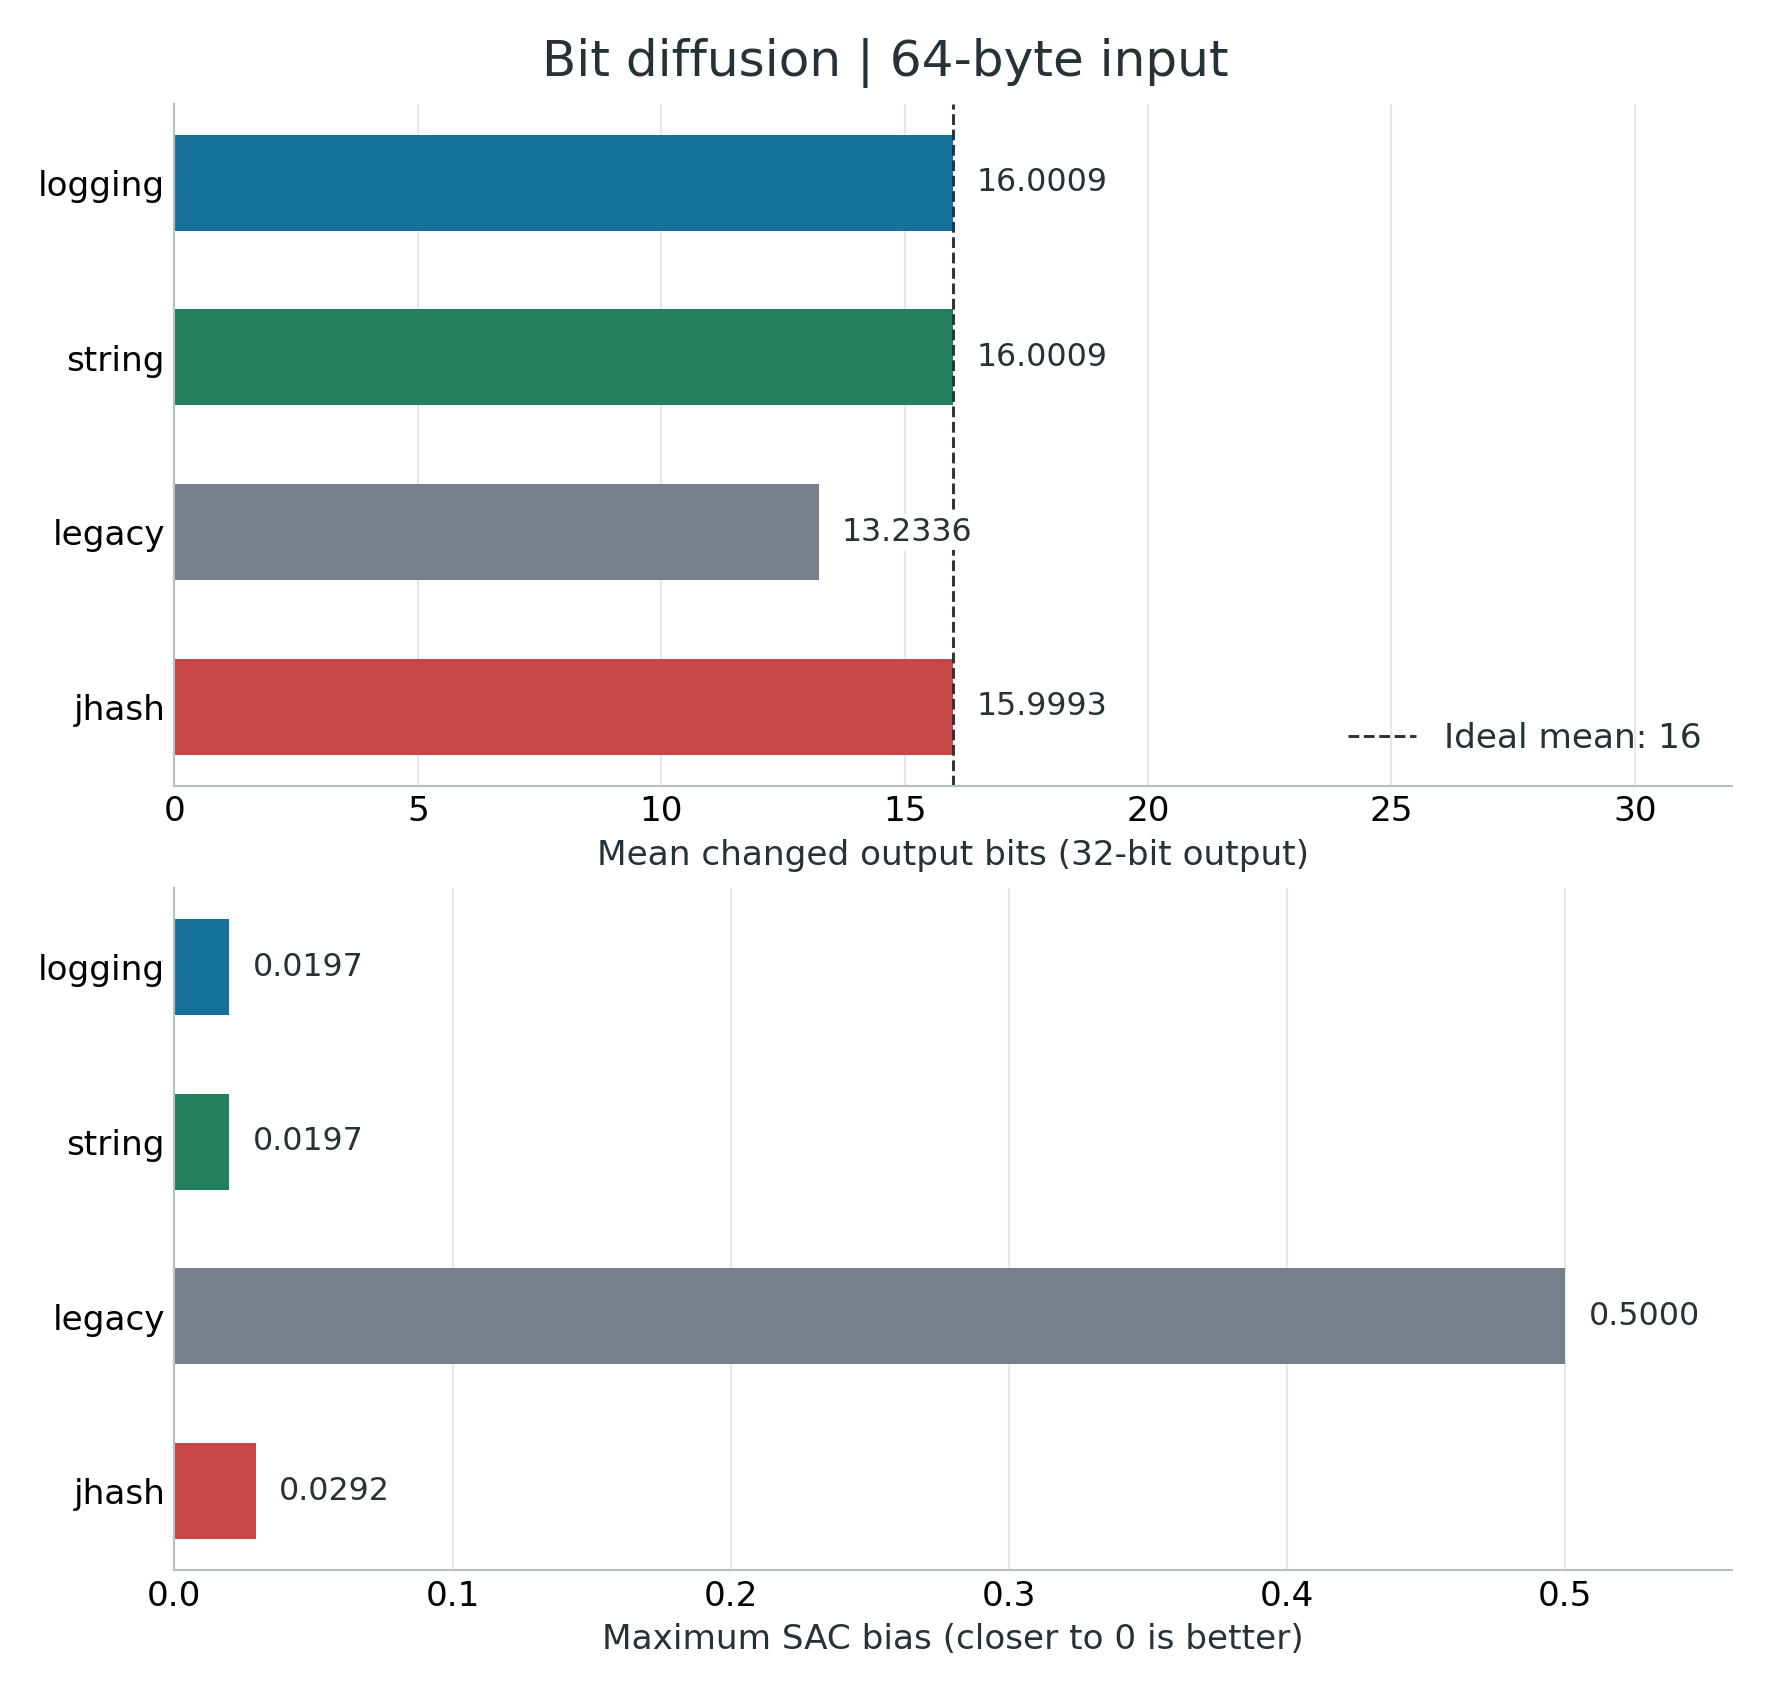 그림 2. 64바이트 입력에서 평균 변경 비트 수와 SAC 최대 편향 비교
입력 한 비트를 바꿨을 때 32비트 출력의 각 비트가 절반의 확률로 바뀐다면, 평균 변경 비트 수는 16이다. logging과 jhash는 이 값에 가까웠다. 다만 평균만으로는 특정 비트 쌍의 편향을 놓칠 수 있어, SAC(Strict Avalanche Criterion)의 최대 편향도 함께 확인했다. 이번 입력에서 legacy는 더 큰 편향을 보였다. jhash의 16·64바이트 최대 편향은 실험의 보수적 99% 동시 오차 기준을 넘어, 다른 시드와 표본으로 확인할 항목으로 남았다. 이는 합성 입력의 확산 평가이며 암호학적 안전성 검증은 아니다.
이를 수식으로 쓰면 다음과 같다. H는 32비트 해시 함수, x는 입력, e_i는 i번째 비트만 1인 마스크다. 입력의 i번째 비트를 반전시켰을 때 출력의 j번째 비트가 바뀔 확률을 p_ij로 나타낸다. D_i는 그때 바뀐 출력 비트 수이며, 이상적 모델에서는 각 변화 확률이 1/2이다.
그림 2의 평균 변경 비트는 첫 번째 관점, SAC 최대 편향은 마지막 식에 대응한다. 평균이 16에 가깝더라도 특정 비트 쌍의 변화 확률이 치우칠 수 있으므로 두 값을 함께 본다.
출력 충돌은 서로 다른 입력이 같은 해시값을 만드는 경우다. n개 입력의 출력이 M개의 값에 균등하고 독립적으로 분포한다고 가정하면, 충돌 쌍 수 C의 기댓값은 다음과 같다.
20만 개의 서로 다른 64바이트 random 키에서 logging과 jhash는 각각 5쌍의 출력 충돌을 보였다. 이는 균등 모델의 기댓값과 가까운 관측이며, 정확히 4.657쌍이 나와야 한다는 뜻은 아니다. 구현의 0→2 정규화까지 고려하면 한 쌍의 충돌 확률은 아래처럼 아주 조금 증가한다.
시작 버킷 충돌은 출력 충돌과 다르다. 서로 다른 해시값도 같은 시작 버킷을 가리킬 수 있다. 버킷 b에 배정된 키 수를 O_b, 버킷 수를 B라 하면, 같은 버킷에 배정된 키 쌍을 합산해 비교할 수 있다.
균등·독립 버킷 선택 모델과 비교하면, logging의 304,510쌍과 jhash의 305,516쌍은 비슷한 범위다. 이것은 삽입 전 시작 위치의 분포다. 항목을 이동시킨 뒤의 조회 비용은 테이블에 넣어서 따로 측정했다.
해시 계산 비용
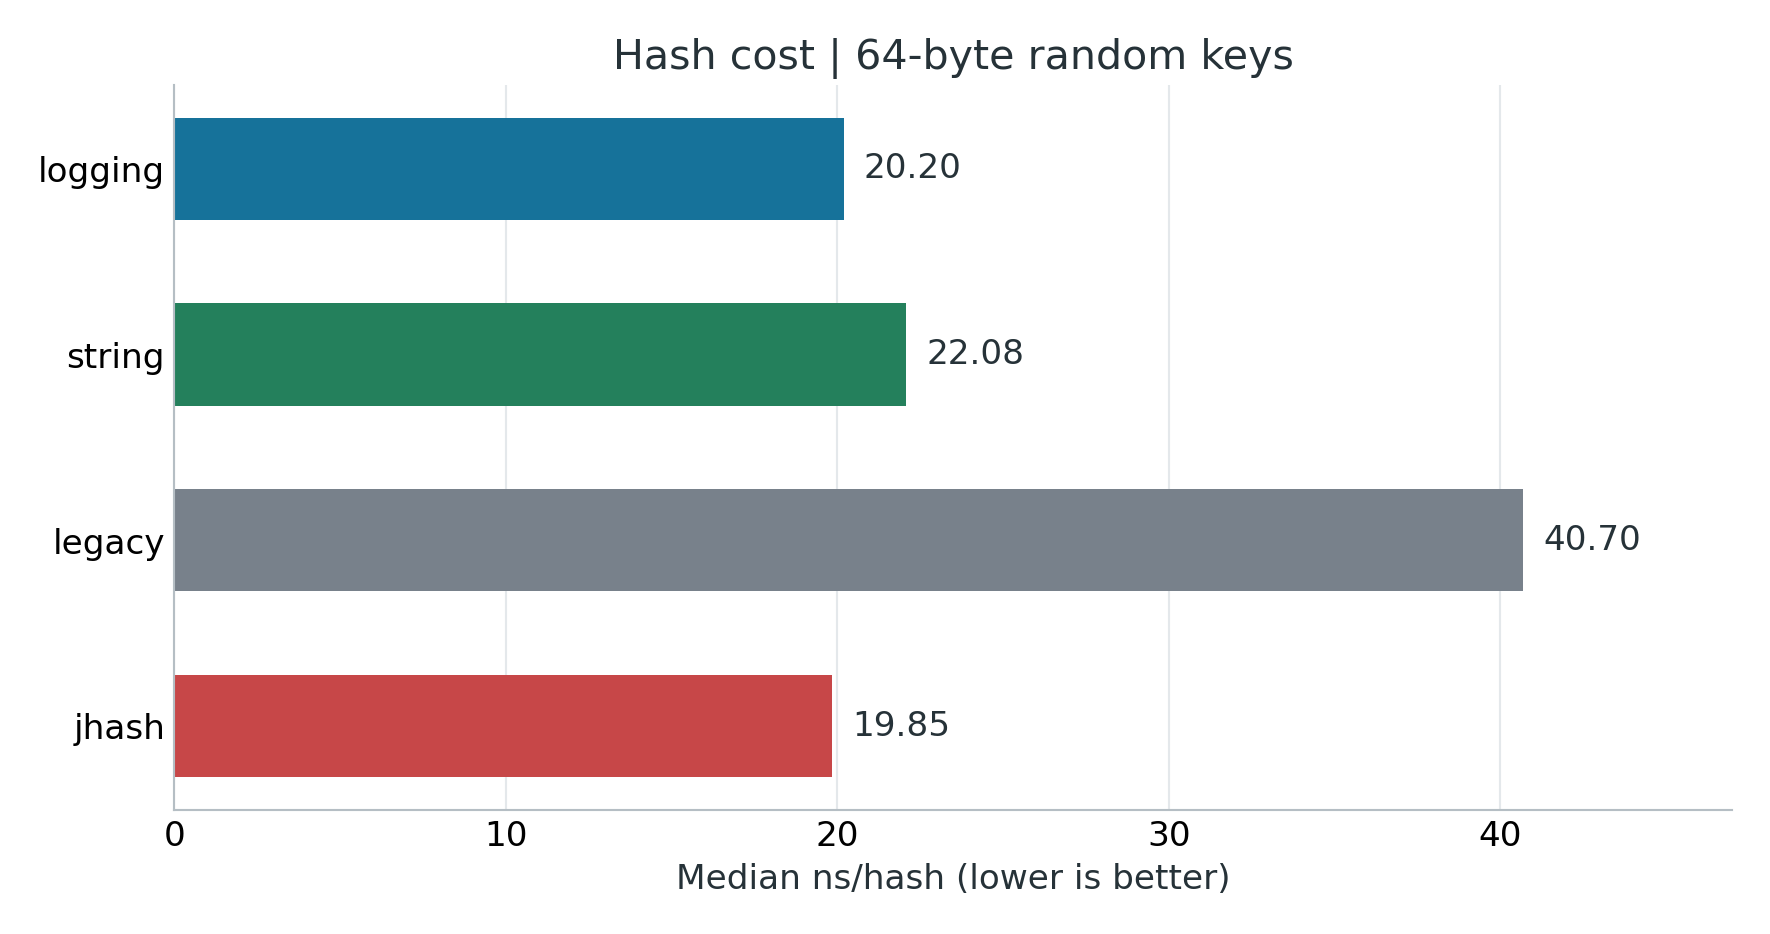 그림 3. 64바이트 random 입력의 해시당 중앙값 계산 시간 비교
logging은 20.20 ns/hash, jhash는 19.85 ns/hash로 근접했다. 같은 SipHash 코어를 사용하는 string은 strlen()까지 포함해 22.08 ns/hash였다. 이 비교는 동일한 해시 코어라도 입력을 처리하는 경로가 다르면 측정 비용이 달라진다는 점을 보여준다. 64바이트 키 특화는 이러한 입력 조건을 코드에 명시한 선택이었다.
각 실행에서 해시를 K번 계산하는 데 걸린 시간이 T라면, 해시당 평균 시간은 아래와 같다. 그래프는 이렇게 얻은 실행별 값의 중앙값을 표시한다.
상대 차이를 계산하면 logging의 시간은 string 대비 약 8.51% 짧았고, jhash 대비 약 1.76% 길었다. 아래에서 R_string은 string 대비 시간 감소율, Delta_jhash는 jhash 대비 시간 증가율이다. 분모가 무엇인지에 따라 비교 의미가 달라지므로 기준 경로를 명시한다.
짧은 8·16바이트 입력에서는 jhash가 string보다 빨랐다. 따라서 64바이트 조건의 결과를 모든 키 길이로 확대할 수는 없다. 측정에는 함수 호출·키 접근·반복 루프·정규화 등이 포함되며, 단일 호출의 순수 산술 연산 시간은 아니다. CPU 사이클도 같은 방식으로 총 사이클 C_cpu를 K로 나누어 정의할 수 있지만, 이번에는 하드웨어 카운터 접근 제한으로 실제 값을 확보하지 못했다.
점유율과 탐색 거리
해시 함수가 비슷하게 분산된다고 해서 실제 조회 비용까지 같다는 결론을 바로 내릴 수는 없다. Robin Hood 삽입 이후의 PSL과 확인 슬롯 수를 보기 위해, logging과 jhash를 같은 SHashTable에 적용했다. 이 실험은 해시 함수만 바꾼 SHashTable끼리의 비교이며, GHashTable이나 Linux 커널 해시 테이블과의 직접 비교는 아니다.
용량은 262,144슬롯으로 미리 확보하고 25·50·70·75% 점유율에서 비교했다. random 입력은 무작위 hex 본문과 고유 접미사로, sequential 입력은 공통 접두사와 순차 증가 접미사로 구성했다. 각 비교에는 동일한 키와 삽입 순서, 재현 가능한 시드 설정을 사용했다.
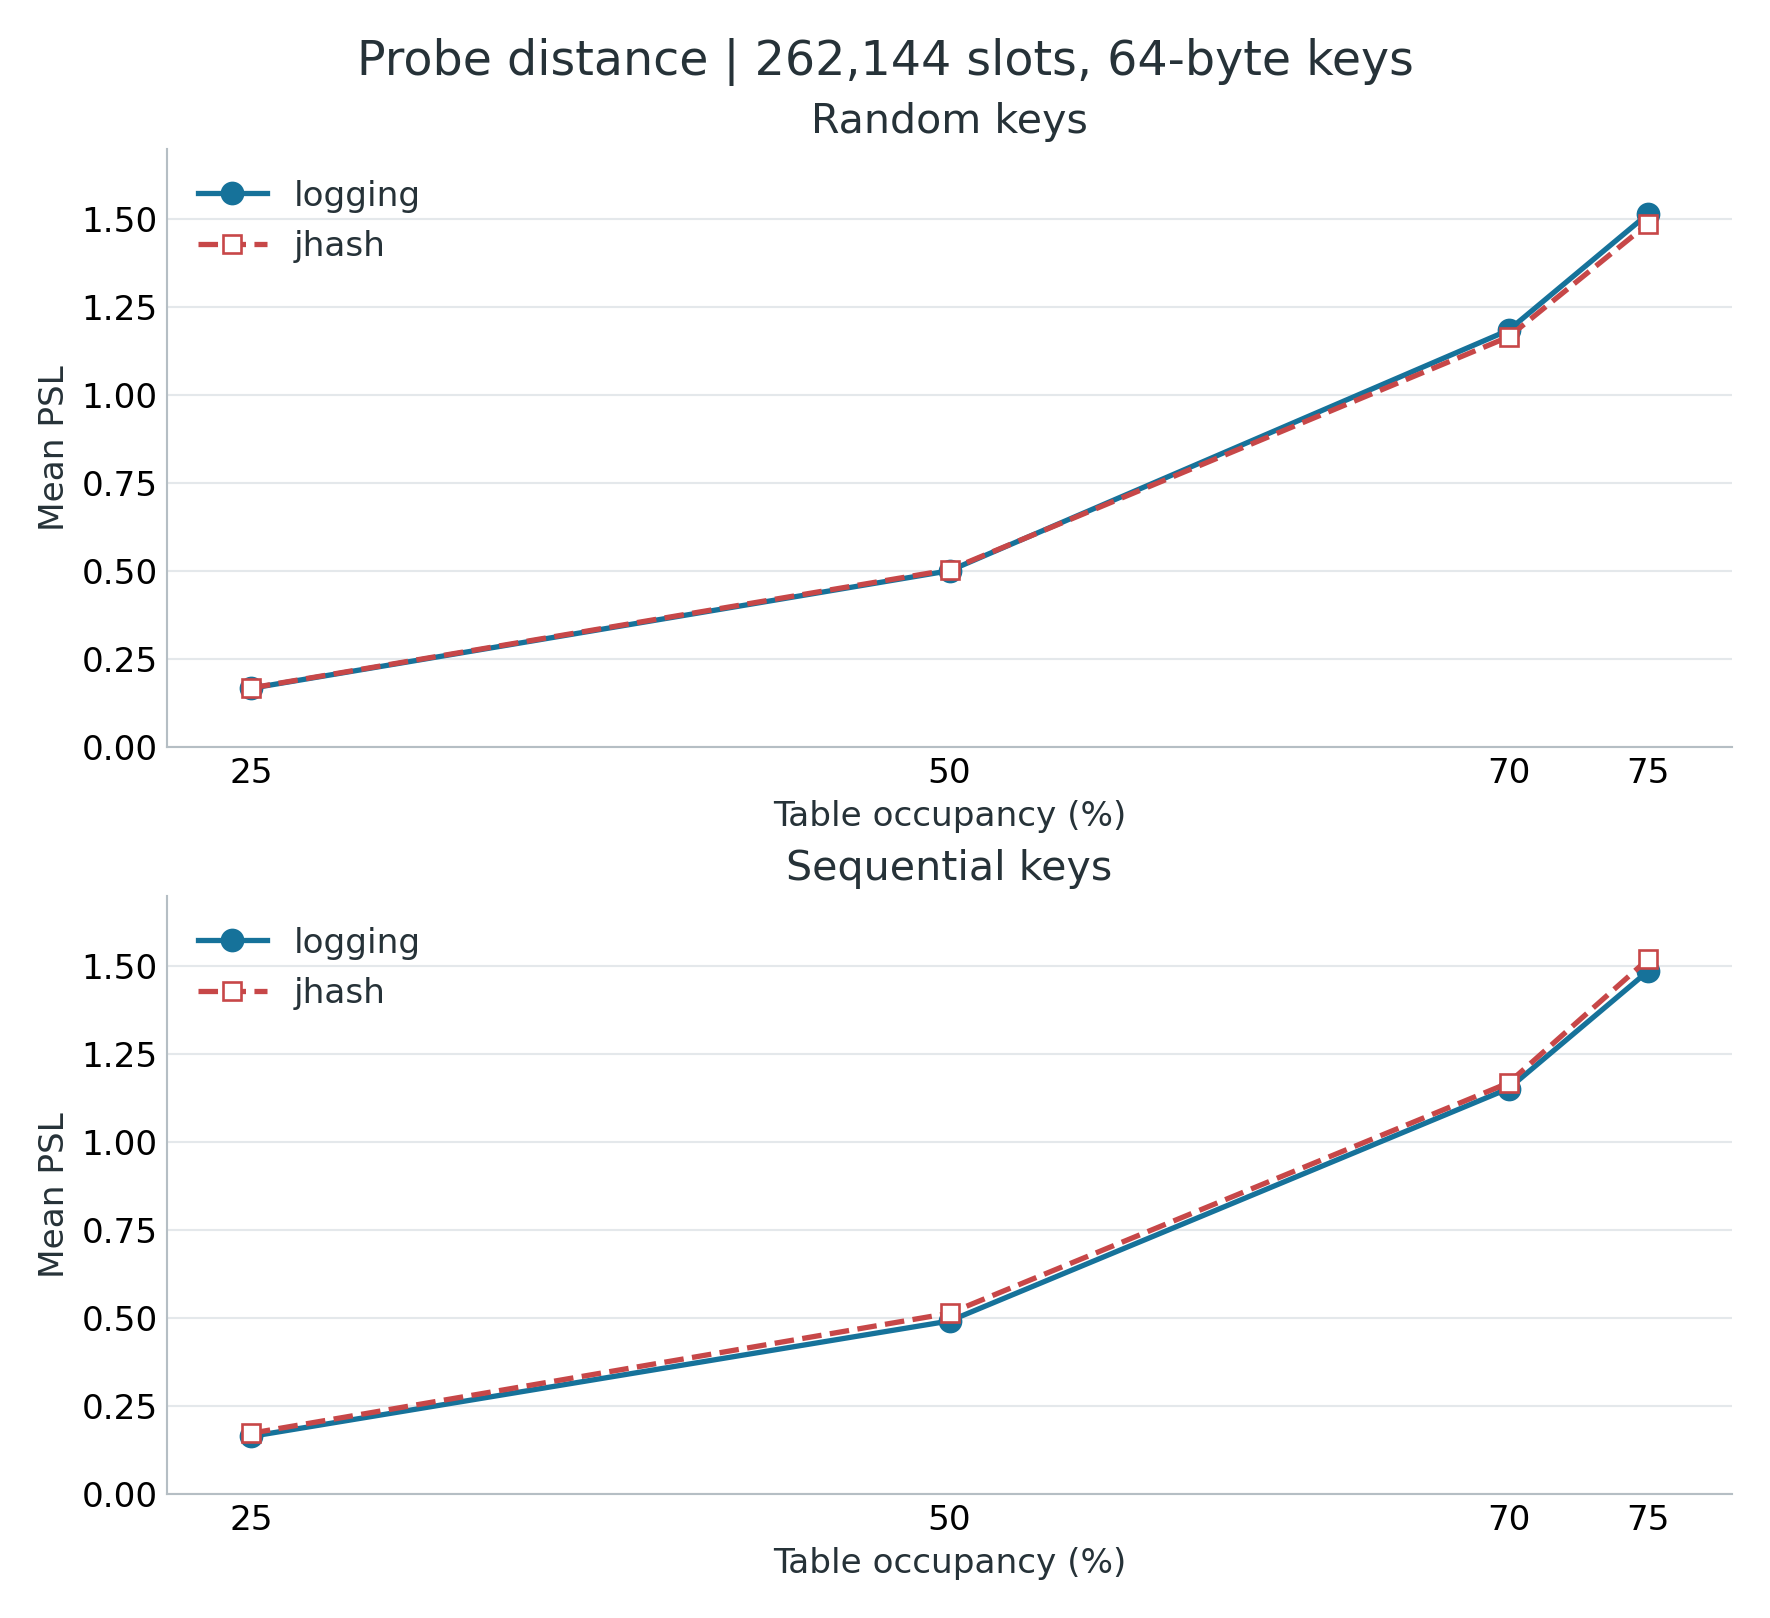 그림 4. random·sequential 입력의 점유율별 평균 PSL 비교
그래프에서 더 큰 변화는 해시 간 차이보다 점유율 증가에 따른 것이었다. random 키의 점유율이 25%에서 75%로 늘어나는 동안 logging의 평균 PSL은 0.167에서 1.515로 증가했다. jhash도 0.168에서 1.487로 비슷하게 변했다. sequential 입력에서도 두 경로는 가까운 탐색 거리를 보였다.
테이블 크기를 B, 항목 i의 최종 위치를 s_i, 시작 위치를 h_i라 하면 PSL은 원형 배열에서 이동한 거리다. n개 항목의 평균 PSL과 성공 조회 평균 확인 슬롯 수는 다음처럼 연결된다.
각 저장 키를 같은 횟수로 조회하는 이번 조건에서 logging은 1+1.515=2.515개, jhash는 1+1.487=2.487개의 슬롯을 평균적으로 확인했다. 성공 조회의 p99 확인 슬롯 수는 두 경로 모두 9개였다. 여기서 p99는 지연시간이 아니라 탐색한 슬롯 수의 분포를 뜻한다.
삽입과 조회 시간
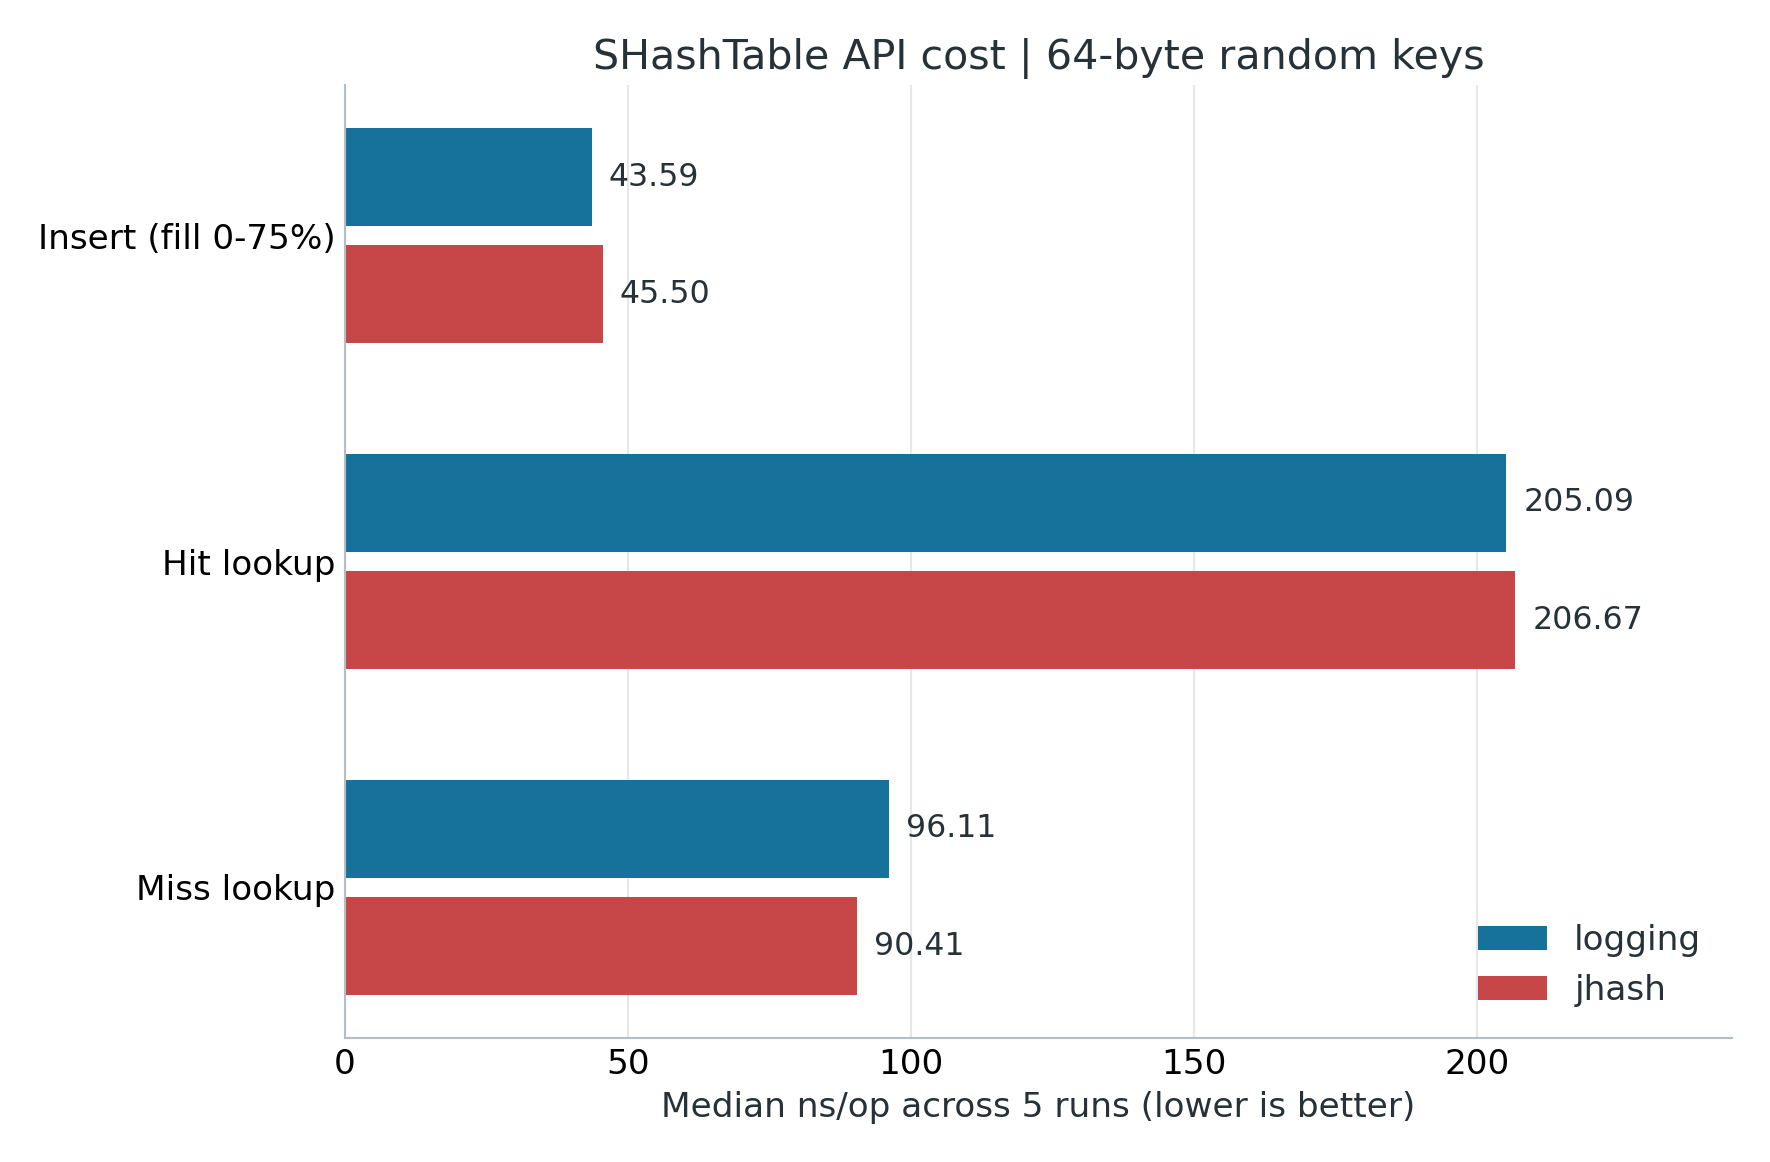 그림 5. 64바이트 random 키의 삽입·성공 조회·실패 조회 시간 비교
실제 API 시간에서도 어느 한 경로가 모든 연산에서 일관되게 앞서지는 않았다. 삽입과 성공 조회는 근접했고, 실패 조회에서는 jhash가 더 짧은 시간을 보였다. 성공 조회가 해시 함수 단독 측정보다 오래 걸리는 것은 이 측정이 해싱뿐 아니라 실제 슬롯 탐색과 키 비교, 반환, 반복 루프까지 포함하기 때문이다. 이번 결과의 핵심은 특정 함수의 작은 우위보다, 64바이트 logging 경로가 테이블 탐색에서도 비교 가능한 비용을 보였다는 점이다.
jhash를 기준으로 한 시간 감소율 R을 정의하면, 양수는 logging의 시간이 더 짧다는 뜻이고 음수는 더 길다는 뜻이다.
즉 중앙값 기준으로 삽입은 4.20%, 성공 조회는 0.76% 짧았지만, 실패 조회는 6.30% 길었다. 이는 제공된 반올림 수치로 계산한 상대 시간 차이이며, 반복 측정의 분산을 이용한 통계적 유의성 판정은 아니다.
시간은 계수기가 없는 원본 구현에서 5회 측정한 중앙값이며, 탐색·교환 횟수는 별도의 계수용 빌드에서 측정했다. 삽입은 빈 테이블을 75%까지 채우는 전체 평균이고, 조회는 75% 점유 상태에서 측정했다. 생성·메모리 할당·리사이징은 시간 측정에서 제외했다. 성공 조회에는 저장된 키와 별도로 복사한 키 버퍼를 사용했다. 이 조건은 고정 용량에서 삽입과 조회를 비교하기 위한 것이며, 실제 로그의 hot-key 분포나 삭제·재삽입 반복 비용을 포함한 결과는 아니다.
개발을 돌아보며
SHashTable은 최종적으로 회사의 GHashTable 대체 구현으로 채택되지는 않았다. 이 글의 실험도 GHashTable보다 빠르다는 것을 보여주는 자료는 아니다. GLib 의존성과 유지보수라는 문제에서 출발해, 기존 호출 형태를 유지하고 64바이트 키를 처리하는 독립적인 테이블을 구현한 과정을 기록한 것이다.
대체 구현을 만들면서 다뤄야 했던 것은 해시 함수 하나가 아니었다. 호출부의 변경 범위를 줄이는 API, key/value 소유권, 충돌 이후의 배치, 삭제와 리사이징까지 연결되어 있었다. 직접 관리하는 구현을 선택하면 외부 의존성을 줄이는 대신 그 동작을 검증하고 유지하는 책임도 함께 가져온다. 그래서 이 개발 경험을 돌아볼 때는 계산 속도뿐 아니라 어떤 사용 조건을 코드에 담았고, 어디까지 측정했는지를 함께 남기고 싶었다.
참고 자료
구조 설명은 직접 개발한 shash.h, shash.c, hashtable.h, hashtable.c를 기준으로 했다. 그래프는 별도로 정리한 실험 기록의 요약값을 사용했다. 실행별 원시 값이 없는 항목에는 에러바를 넣지 않았으며, 이 글을 수정하면서 벤치마크를 재실행하지는 않았다. 그래프 생성에 사용한 수치와 코드는 재현용 스크립트에서 확인할 수 있다.