모니터랩에 입사하고 수습 과제로 Mini-IPS를 개발했다. 악성 HTTP 요청을 정규표현식으로 탐지하고 차단하는 시스템이다. 탐지 엔진은 PCRE2와 Hyperscan을 각각 붙여 성능을 비교했다.
1차에서는 libpcap으로 미러링 트래픽을 받아 처리했다. 동작은 했지만 차단율이 낮았고, 정상 요청을 공격으로 판단하는 경우도 많았다. 요청이 없어도 워커가 CPU 코어 하나를 거의 전부 사용했다. 2차에서는 TPROXY 기반 인라인 구조로 바꾸고, 대기 방식과 HTTP 전처리도 함께 수정했다.
그 결과 GoTestWAF의 공격 298건을 모두 차단했고, 정상 요청 오탐률은 39.0%에서 5.7%로 줄었다. 엔진 간 차이는 대용량 요청에서 뚜렷했다. 1MB SQLi 요청을 1,000회 보냈을 때 PCRE2는 372초, Hyperscan은 15초가 걸렸다.
미러링으로 시작한 Mini-IPS
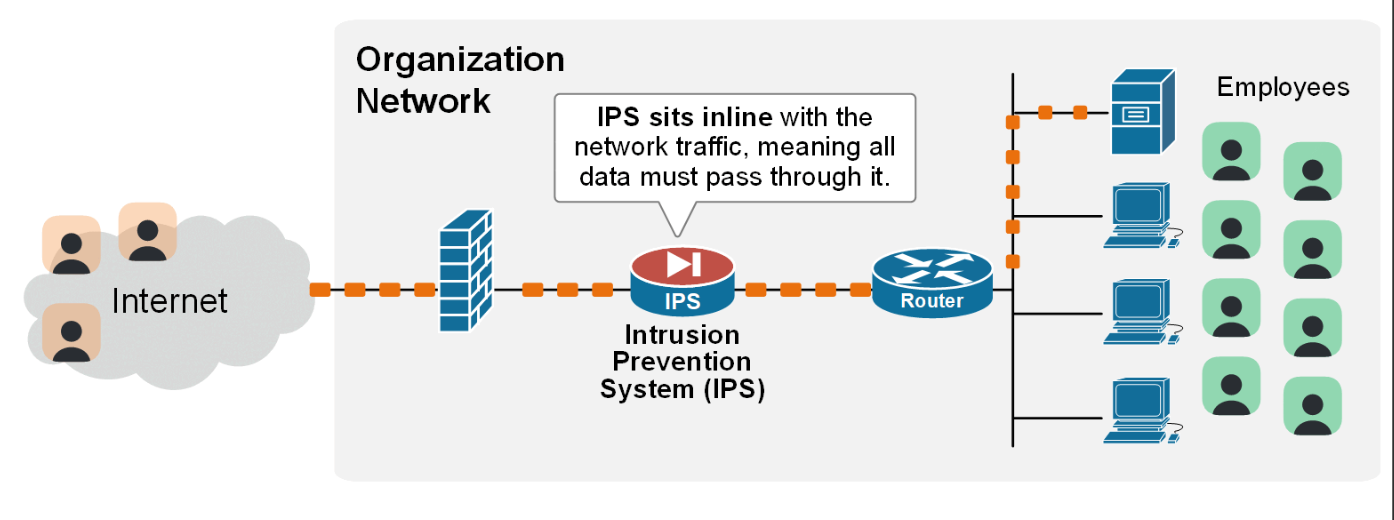
IDS는 공격을 탐지하고 알리는 시스템이고, IPS는 탐지한 공격을 차단하는 시스템이다. 이번 과제에서는 알려진 공격 패턴을 정규표현식으로 검사하는 시그니처 기반 방식을 사용했다.
처음부터 인라인으로 구현한 것은 아니었다. 1차 과제는 libpcap으로 패킷을 수집하는 미러링 방식이었다. 복제된 패킷을 분석하고, 공격이 발견되면 TCP RST나 HTTP 403 응답을 보내 차단을 시도했다.
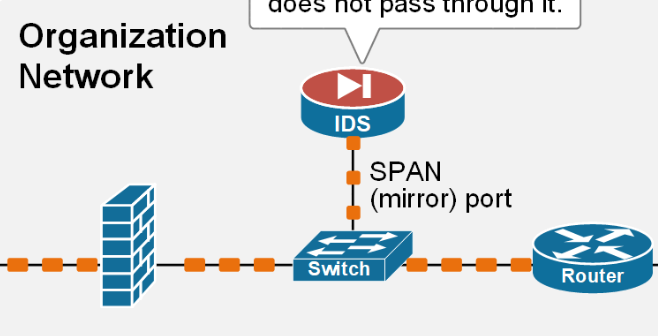
문제는 패킷을 보는 시점이었다. 미러링으로 받은 패킷은 복사본이고, 원본은 이미 서버로 이동하고 있다. 공격을 찾았을 때 서버가 요청을 받은 상태라면 늦게 연결을 끊어도 그 요청의 실행을 막기 어렵다.
RST를 보내는 과정도 복잡했다. 세션을 추적하면서 SEQ/ACK를 맞춰야 했고, 서버와 클라이언트가 보내는 패킷 사이에 RST를 전달해야 했다. 탐지 로직을 만드는 것과 실제 요청을 막는 것은 별개의 일이었다.
첫 번째 구조에서 생긴 문제
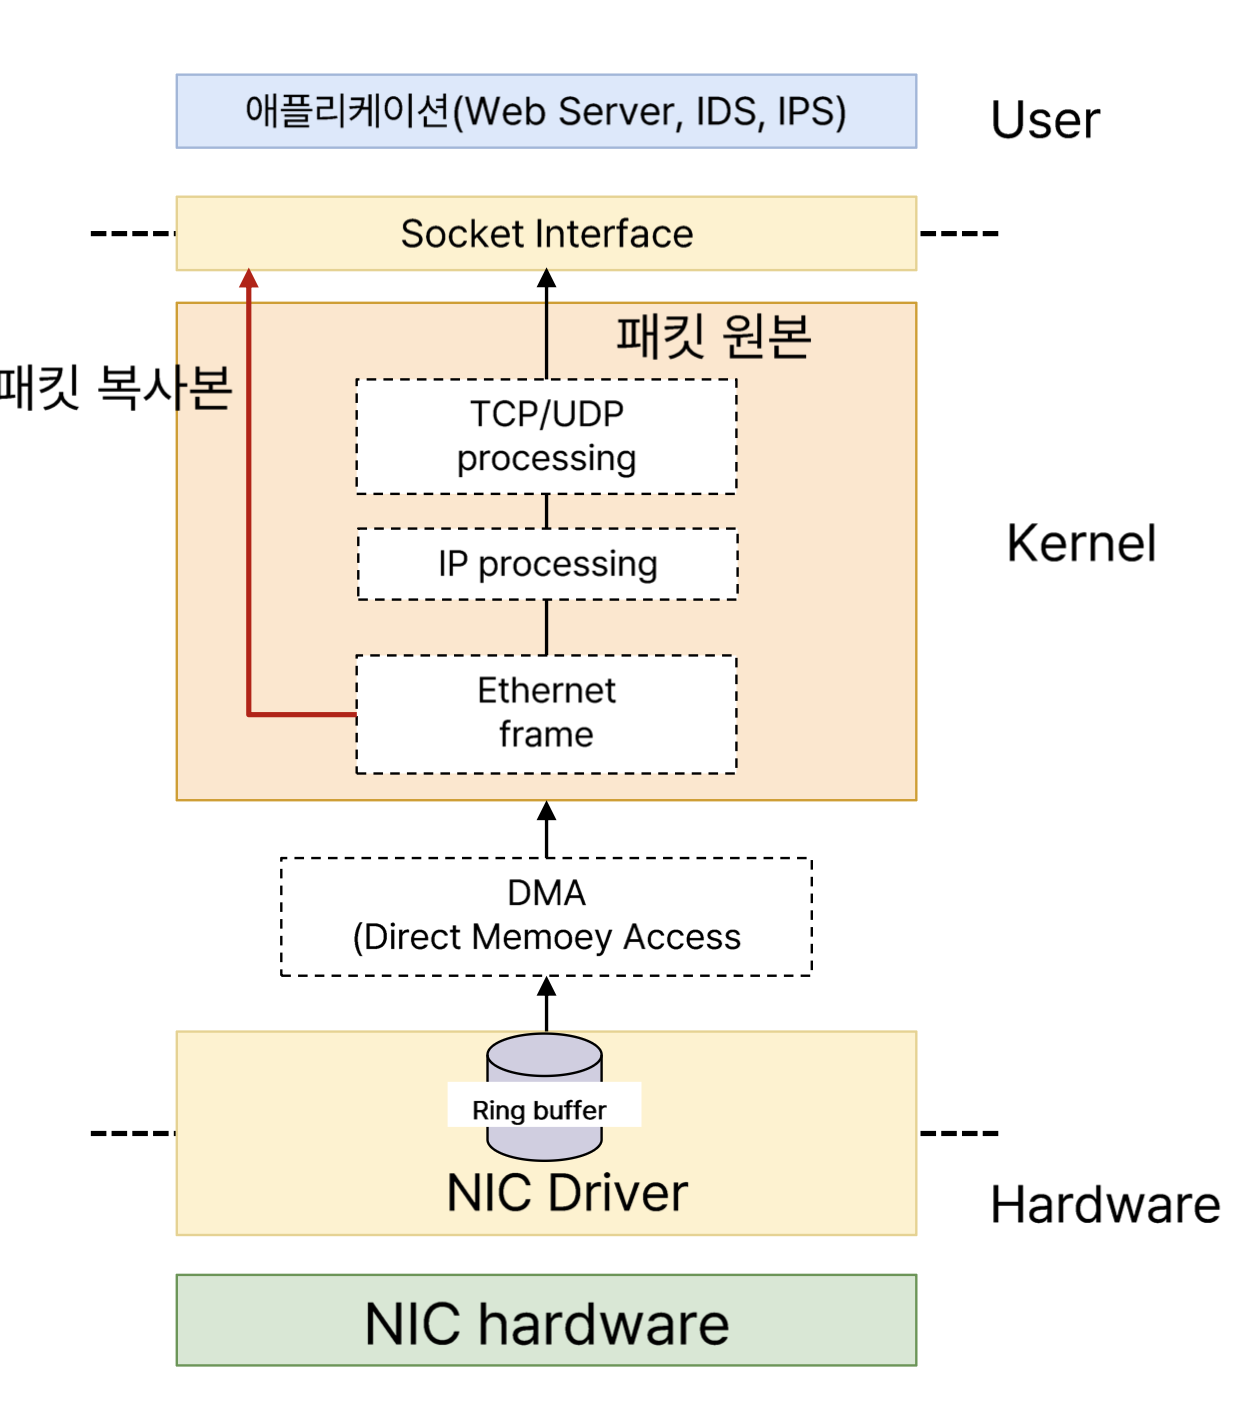
libpcap은 네트워크 패킷을 캡처하는 라이브러리다. 커널의 캡처 경로를 통해 사용자 공간에서 패킷을 받아 처리한다. 이 패킷을 바탕으로 TCP 스트림을 재조립하고 HTTP 메시지를 만드는 부분은 직접 구현했다.
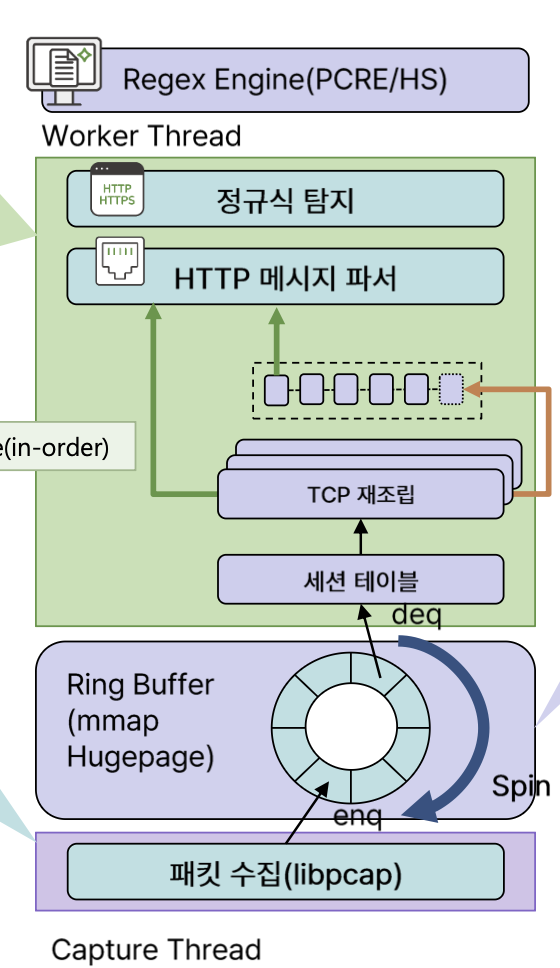
캡처 스레드는 패킷을 수집해 링 버퍼에 넣고, 워커는 버퍼에서 패킷을 꺼내 다음 작업을 수행했다.
- 세션을 찾고 TCP 바이트 스트림을 재조립한다.
- 스트림에서 HTTP 메시지를 조립한다.
- 정규표현식으로 공격 패턴을 검사한다.
- 탐지 결과에 따라 차단 패킷을 전송한다.
링 버퍼는 Hugepage에 매핑했고, head와 tail은 원자적으로 갱신했다. 워커를 여러 개 두어 처리량을 늘리려 했지만 실제 구현은 기대만큼 병렬로 동작하지 않았다.
가장 눈에 띈 문제는 스핀 루프였다. 워커가 링 버퍼를 계속 확인하는 구조여서, 트래픽이 없어도 해당 코어의 사용률이 99–100%에 달했다. 패킷 처리보다 작업을 기다리는 데 CPU를 쓰고 있었다. 두 번째 구현에서는 이 대기 방식을 먼저 바꿨다.
TPROXY로 인라인 구조 만들기
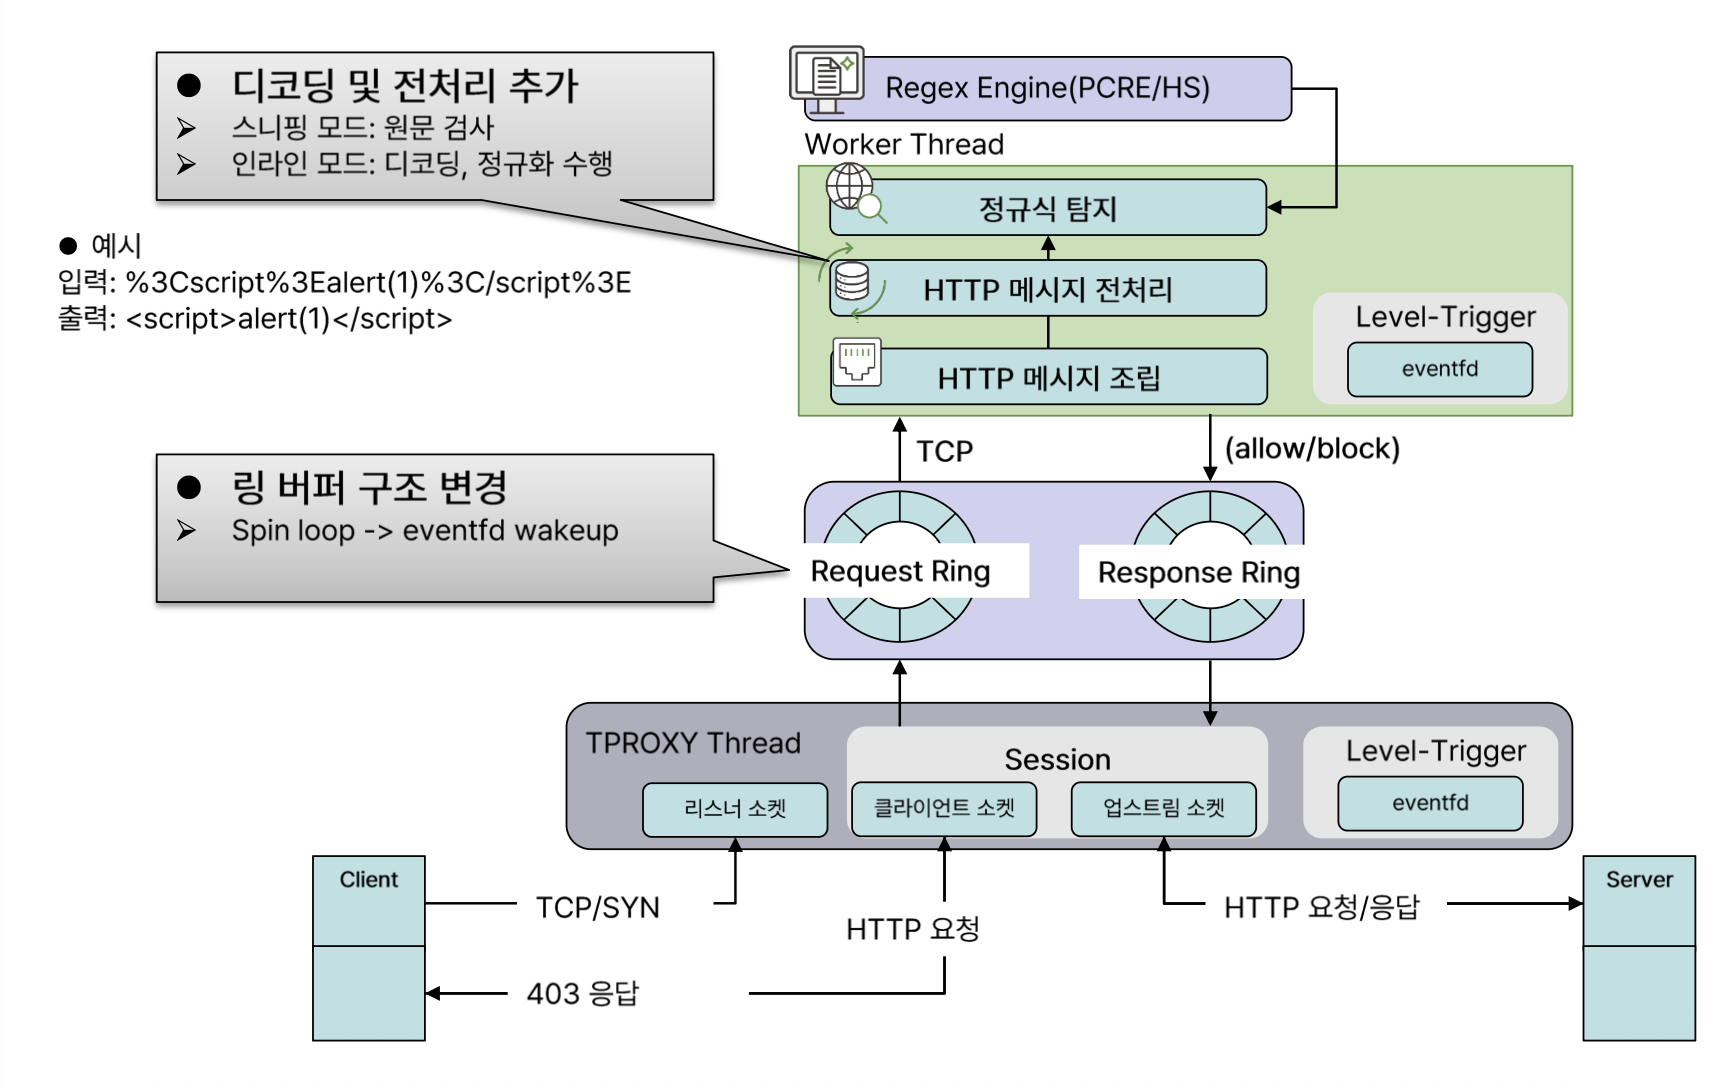
2차에서는 TPROXY로 클라이언트 요청을 로컬 프록시 소켓으로 받아 처리했다. 원래 목적지 주소를 유지하면서, 요청을 검사한 뒤 업스트림으로 전달하는 구조다. 공격을 탐지하면 업스트림으로 보내는 대신 클라이언트에 403 응답을 반환했다.
TPROXY 스레드는 클라이언트 소켓과 업스트림 소켓, 세션을 관리했다. 워커는 HTTP 메시지 조립과 전처리, 정규식 탐지를 담당했다. 요청과 응답에는 각각 별도의 링 버퍼를 뒀다.
소켓 이벤트는 epoll로 확인하고, 링 버퍼에 작업이 들어오면 eventfd로 워커를 깨웠다. 버퍼가 비어 있어도 계속 반복하던 스핀 루프를 작업 도착에 맞춰 깨어나는 방식으로 바꾼 것이다.
미러링에서는 지나간 요청을 뒤늦게 막으려 했다면, 인라인에서는 전달할 요청을 직접 검사하게 됐다. 차단 위치가 바뀌면서 연결 관리와 탐지 흐름도 훨씬 정리하기 쉬워졌다.
정규식만 가져오면 끝날 줄 알았다
룰은 OWASP Core Rule Set에서 수집했다. 처음에는 ModSecurity용 룰에서 정규표현식만 추출해 사용했다. 그런데 정상 요청까지 공격으로 판단하는 경우가 많았다. 검사 대상과 변환 과정이 빠진 채 패턴만 적용한 것이 문제였다.
인코딩된 공격을 놓치는 문제도 있었다. 예를 들어 %3Cscript%3Ealert(1)%3C/script%3E는 디코딩하면 <script>alert(1)</script>가 되지만, 원문만 검사하던 1차 구현에서는 탐지하지 못했다.
2차에서는 AI를 활용해 정규식을 정제하고, HTTP 메시지를 URI·헤더·본문으로 나눠 전처리했다. Percent Decode, HTML Entity Decode, Escape Decode, Base64 Flat Decode와 정규화를 추가했다. 원문에 정규식만 적용하던 구조에서, 입력을 해석한 뒤 검사하는 구조로 바꿨다.
PCRE2와 Hyperscan
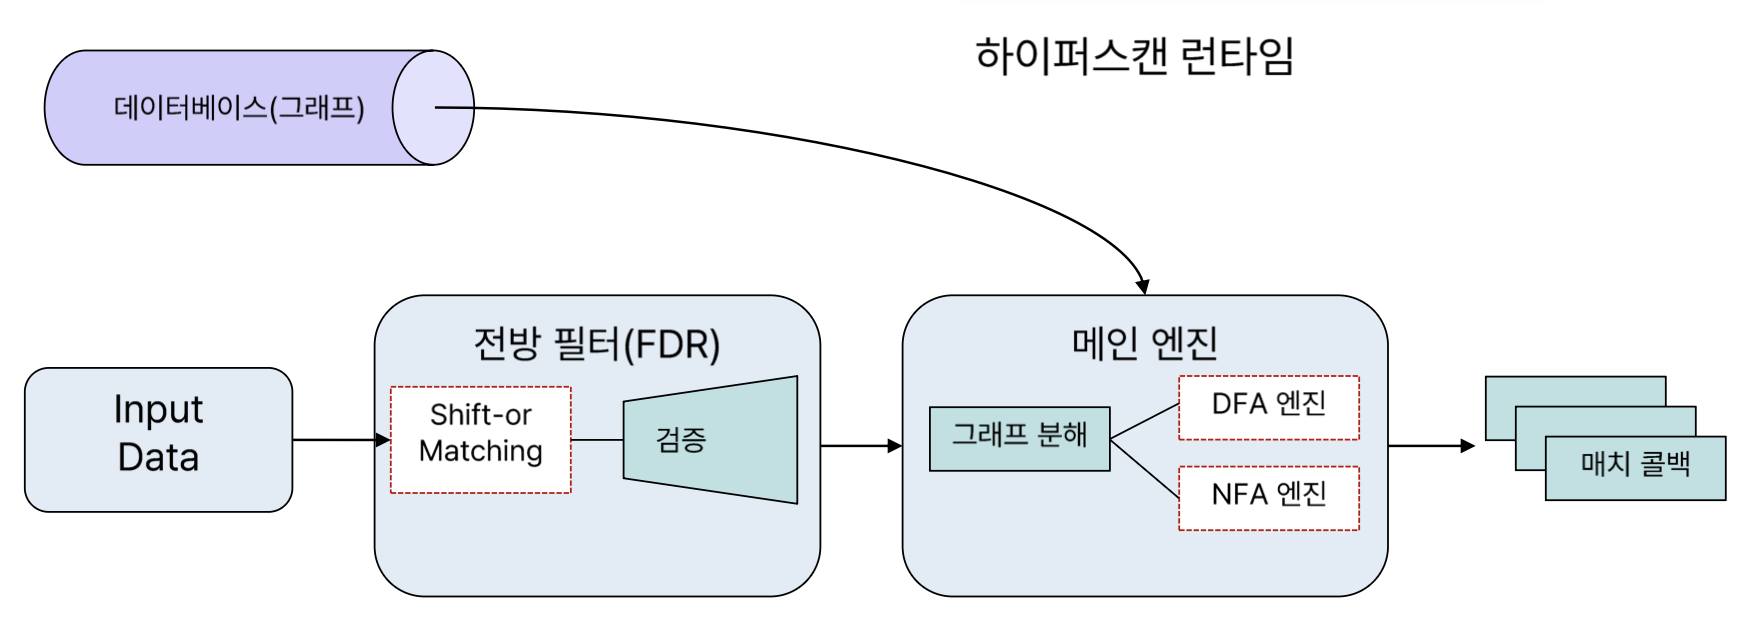
PCRE2는 Perl 호환 정규표현식 라이브러리다. 인터프리터로 패턴을 실행하며, JIT를 사용하면 지원되는 패턴을 기계어로 컴파일해 반복 매칭을 빠르게 처리한다.
Hyperscan은 여러 패턴을 하나의 데이터베이스로 컴파일해 검사한다. SIMD와 패턴별 탐색 기법을 활용해 다중 패턴 매칭을 최적화한다. 패턴마다 검사 함수를 호출하는 방식과 여러 패턴을 묶어 검사하는 방식의 차이가 대용량 입력에서 어떻게 나타나는지 궁금했다.
Hyperscan은 역참조 등 일부 PCRE 문법을 지원하지 않는다. 그래서 룰을 옮길 때는 문법과 검사 방식도 함께 살펴봐야 했다. HTTP 메시지를 만드는 과정은 애플리케이션이 담당하고, 완성된 검사 입력을 정규식 엔진에 전달하는 구조로 비교했다.
실험 환경
실험은 VirtualBox VM에서 진행했다. 기본 평가와 대용량 평가에 같은 환경을 사용했다.
| 항목 | 구성 |
|---|---|
| 운영체제 | Ubuntu 24.04.4 LTS |
| 호스트 CPU | Intel Core i7-11700K @ 3.60GHz |
| VM 할당 CPU | 4 vCPU |
| VM 메모리 | 7.8GiB |
| 가상화 | VirtualBox |
먼저 GoTestWAF로 차단율과 오탐률을 확인했다. 공격 요청은 SQLi, XSS, RCE, 경로 탐색으로 구성된 298건이다. 정상 요청은 공격 키워드처럼 보이는 입력을 포함한 141건을 사용했다.
이후 두 인라인 구현에 같은 종류의 요청을 보내 처리량과 CPU 사용량을 비교했다. 대용량 실험에서는 SQLi 요청의 크기를 늘리고, 공격 구문을 앞·중간·뒤로 옮겼다. 마지막으로 1MB 요청을 1,000회 반복 전송했다.
차단율과 오탐률
| 지표 | 미러링·1차 | 인라인·2차 |
|---|---|---|
| 공격 차단율 | 49.4% | 100.0% |
| 정상 요청 오탐률 | 39.0% | 5.7% |
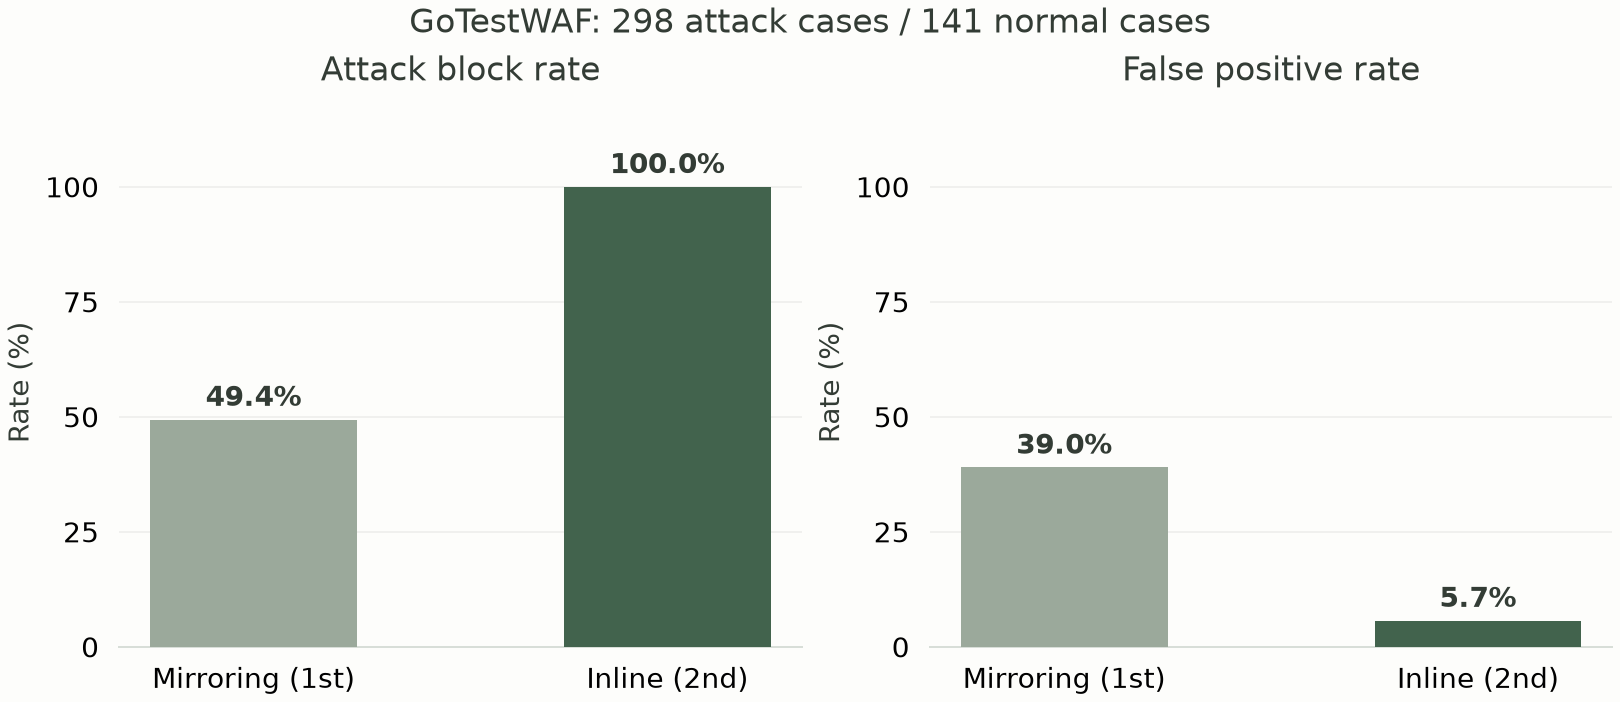
2차 구현은 공격 298건을 모두 차단했다. 정상 요청 오탐률도 33.3%p 줄었다. 인라인 전환으로 요청 전달을 직접 제어했고, 룰 정제와 디코딩을 통해 잘못된 탐지와 인코딩 우회를 줄였다.
초기에는 차단 동작과 정규식 엔진에 집중했는데, 결과를 보니 입력을 어떻게 나누고 전처리하는지도 그만큼 중요했다. 오탐률이 5.7%까지 내려간 만큼, 남은 정상 요청의 오탐 사례를 따로 분석하는 것이 다음 작업이다.
작은 요청에서는 차이가 크지 않았다
평균 패킷 크기가 약 890바이트인 기본 워크로드의 처리량은 다음과 같다. RPS는 초당 처리한 요청 수다.
| 입력 | PCRE2 | Hyperscan |
|---|---|---|
| 공격 요청 | 358.86 RPS | 372.50 RPS |
| 정상 요청 | 88.10 RPS | 84.90 RPS |
공격 요청에서는 Hyperscan이 약 3.8% 높았고, 정상 요청에서는 PCRE2가 조금 높았다. 작은 입력에서는 두 구현의 처리량이 비슷했다.
CPU 사용량은 Hyperscan 쪽이 더 높았다.
| 입력 | PCRE2 | Hyperscan |
|---|---|---|
| 공격 요청 | 약 4.3% | 12.37% |
| 정상 요청 | 6.15% | 10.99% |
이 워크로드에서는 Hyperscan으로 바꿔 얻는 처리량 이점이 크지 않았다. 작은 요청의 결과만 봤다면 PCRE2를 사용하는 것도 충분한 선택이었다. 페이로드를 늘리자 결과가 달라졌다.
공격 구문을 뒤로 옮겨봤다
1·4·16·64·128KB SQLi 요청을 만들고, 공격 구문을 앞·중간·뒤에 배치했다. 요청이 길어졌을 때 공격 위치가 처리 시간에 미치는 영향을 보기 위한 실험이다.
128KB 요청의 끝에 공격 구문을 넣었을 때 PCRE2는 약 54ms, Hyperscan은 약 2.1ms가 걸렸다. 약 25배 차이였다. PCRE2는 입력 크기가 커지고 공격 구문이 뒤에 있을 때 처리 시간이 크게 늘었다. Hyperscan은 같은 조건에서 증가 폭이 작았다.
16MB 요청에서는 약 6배 차이
다음 실험에서는 SQLi 요청을 1KB부터 16MB까지 늘려 크기별로 한 번씩 전송했다. 16MB 요청의 결과는 다음과 같다.
| 지표 | PCRE2 | Hyperscan |
|---|---|---|
| 처리 시간 | 약 7.1초 | 약 1.18초 |
| CPU 사용량 | 약 26% | 약 4.5% |
Hyperscan은 PCRE2보다 약 6배 빠르게 처리했다. PCRE2의 처리 시간이 페이로드 크기에 따라 가파르게 늘어난 반면, Hyperscan은 증가 폭이 완만했다. CPU 사용량도 작은 요청 실험과 반대로 Hyperscan이 낮았다.
1MB 요청 1,000회: 372초와 15초
대용량 요청이 계속 들어오면 차이가 얼마나 벌어질지 확인하기 위해 1MB SQLi 요청을 1,000회 반복 전송했다.
| 엔진 | 총 처리 시간 |
|---|---|
| PCRE2 | 372초 |
| Hyperscan | 15초 |
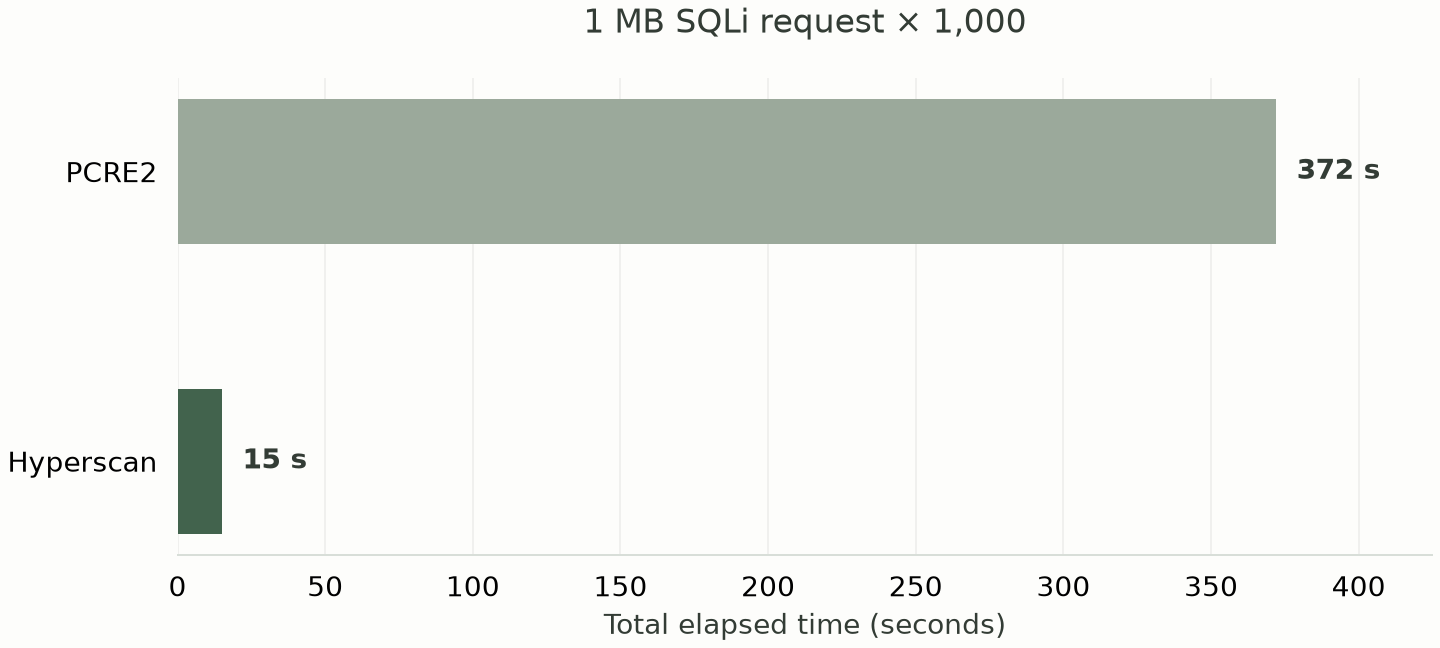
PCRE2는 6분 12초, Hyperscan은 15초가 걸렸다. 총 처리 시간은 약 24.8배 차이가 났고, Hyperscan의 소요 시간은 약 96% 줄었다. 작은 요청에서 보였던 몇 퍼센트의 차이와는 규모가 달랐다.
이때 전체 CPU 사용률은 두 구현 모두 대체로 26–30%였다. 하지만 PCRE2의 코어별 사용량을 보면 한 코어의 사용자 모드 사용률이 95.92%에 달했다. 전체 평균에서는 비슷해 보여도, 한 코어가 계속 바쁘게 도는 상태였다. 4 vCPU 환경에서는 전체 사용률과 코어별 사용률을 같이 봐야 이 차이가 드러났다.
개발을 마치고
처음에는 정규식 엔진을 붙이고 워커를 늘리면 되는 문제로 생각했다. 실제로는 패킷을 어디서 받는지, HTTP 메시지를 어떻게 만드는지, 워커가 어떻게 기다리는지가 먼저였다. 미러링에서는 공격을 찾아도 차단 시점이 늦었고, 스핀 루프는 요청이 없어도 코어를 사용했다. 룰만 추출해서 적용하니 과탐지가 많았고, 디코딩이 없으니 인코딩된 공격을 놓쳤다.
2차에서는 이 문제들을 하나씩 고쳤다. TPROXY로 요청 전달 경로에 들어가고, eventfd로 대기 방식을 바꾸고, HTTP 전처리를 추가했다. 그 위에서 엔진을 비교하니 대용량 입력에서 Hyperscan의 장점이 뚜렷하게 나타났다.
2026년 10월 현재, 이 발표를 계기로 도입을 고민하던 Hyperscan을 도입하게 되었다.