서론
LSM 트리는 키-값 저장소에 널리 사용되는 자료구조다. 쓰기를 모아 순차적으로 저장하는 방식은 효율적이지만, 여러 레벨을 검색하고 병합하는 과정에서 읽기·쓰기·공간 증폭이 발생할 수 있다. GHStore는 최신 값이 위치한 레벨을 기록하는 전역 해시맵으로 이 비용을 줄인다.
논문은 업데이트가 많은 워크로드에서 쓰기, 읽기, 범위 쿼리를 함께 개선하는 것을 목표로 한다.
내 연구에서는 이 구조를 블록체인 상태 저장소와 연결해 검토하고 있다. 동기화와 스마트 컨트랙트 실행에서 어떤 I/O 증폭이 발생하는지 먼저 측정해야 한다. GHStore의 결과를 블록체인 워크로드에 그대로 적용할 수 있는지는 별도의 검증이 필요하다.
LSM 트리에서는 컴팩션으로 데이터를 다시 쓰는 과정이 쓰기 증폭을 만든다. GHStore는 오래된 레코드와 불필요한 레벨 탐색을 줄이는 방향으로 접근한다.
논문이 보고한 결과는 다음과 같다. GHStore의 GHMap은 최신 KV 쌍의 레벨을 기록하므로 읽기 작업에서 위에서 아래로 검색할 필요가 없고 쓰기 유도 압축 작업에서 오래된 레코드를 무시한다. YCSB[ 7 ]를 사용하여 GHStore를 평가하고 널리 사용되는 키-값 저장소(예: RocksDB, Wisckey, PebblesDB)와 비교하여 업데이트 집약적 워크로드의 경우 GHStore가 읽기 대기 시간을 10%~50%, 범위 쿼리 대기 시간을 15%~60% 줄이는 동시에 쓰기 처리량을 4%~55% 증가시킨다는 것을 보여준다. GHStore는 읽기 증폭을 3배, 쓰기 증폭을 1.5배, 공간 증폭을 1.5배 줄인다고 보고한다.
논문의 구성 요소는 다음과 같다.
-
GHmap은 “God-view”의 역할을 하는 효율적인 글로벌 세그먼트 해시맵이다. 최신 KV 쌍의 레벨을 기록하여 오래된 KV 쌍을 적시에 제거하고 레벨별로 데이터를 검색하는 것을 방지한다.
-
GHStore는 GHmap 기반의 키-값 저장소다. 업데이트 집약적 워크로드에서 GHStore는 쓰기, 읽기 및 범위 쿼리에서 동시에 전반적인 성능을 개선한다.
-
실험 결과 GHStore는 널리 사용되는 여러 키-값 저장소(예: RocksDB, Wisckey 및 PebblesDB)보다 성능이 더 우수한 것으로 나타났다.
배경
내 연구에서는 LevelDB를 검토하고 있으며, 이 논문은 RocksDB를 다룬다. 두 저장소 모두 LSM 트리를 사용하지만 구현과 설정이 다르므로 측정 결과를 그대로 옮길 수는 없다.
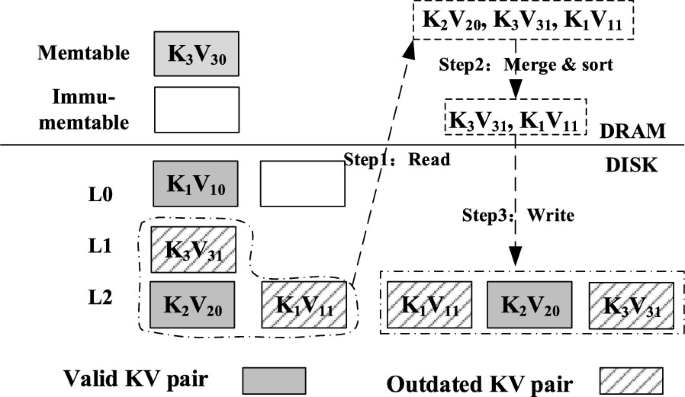
글에서 참고한 연구는 특정 실험 조건에서 큰 읽기·쓰기 증폭을 보고한다. 이러한 수치는 데이터 분포와 설정에 따라 달라지므로 LSM 트리 전체의 고정된 특성으로 해석해서는 안 된다.
워크로드
논문은 70GB 규모의 RocksDB에 100만 개의 get 요청을 수행해 레벨 탐색 비용을 분석한다.
아래 그림은 데이터 분포와 레벨 접근 빈도의 차이를 보여준다.
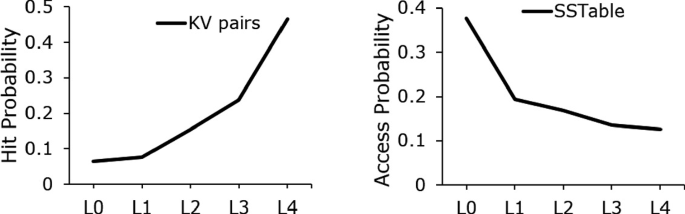
그림을 보면 대부분의 KV 쌍은 높은 수준에 있다. 높은 SSTable에 키-값 데이터가 몰려 있지만, 더 낮은 수준의 SSTable에 더 자주 액세스되고 있다. 이러한 문제는 낮은 레벨에서 높은 레벨까지 자주 접근해야 하기 때문에 읽기 증폭으로 디스크 액세스를 증가시킨다고 한다.
이 주장을 토대로 geth에서도 이러한 분포를 보이는지 확인할 필요가 있다.
전역 분할 해시맵(GHmap)
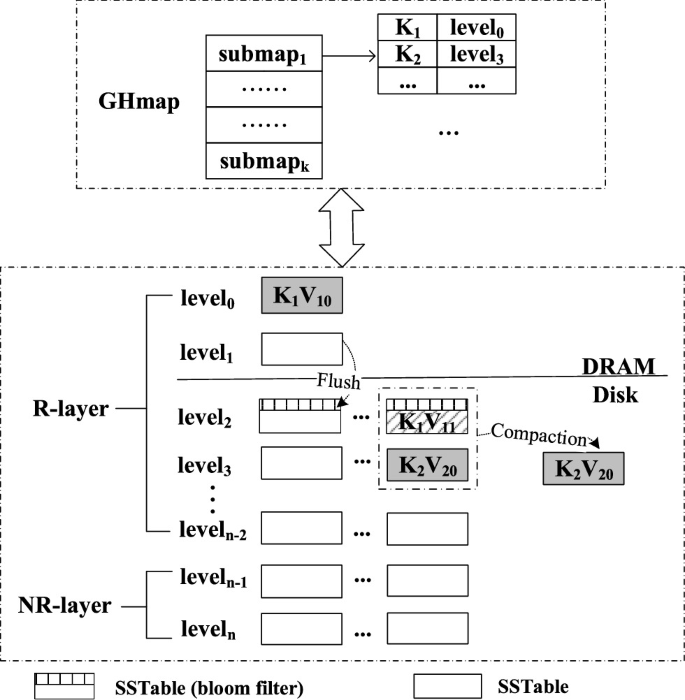
위 그림은 GHStore의 아키텍처다. SSTable 대신 레벨을 기록하는 GHmap을 통해 메모리 소비를 더 제어한다. 이것은 R 계층과 NR 계층으로만 구분되는 LSM 트리에서 R계층의 최신 키값 레벨만 GHmap에 기록한다.
GHStore의 범위 쿼리는 RocksDB와 유사한 탐색 구조를 사용한다.
간단히 말하면 데이터를 업데이트하거나 읽을 때 GHmap도 함께 갱신하거나 메모리로 함께 읽어들인다는 의미다.
get같은 경우는 GHmap을 먼저 탐색해서 레코드를 찾고 없을 경우 NR 계층에서 SSTable을 탐색한다.
데이터베이스 시스템이기 때문에 복구 프로세스 또한 존재하는데, 일종의 체크포인트를 두고, 전부 복구하는 프로세스를 수행하지 않는다. 최신 체크포인트로 GHmap을 초기화하는 구조로 프로세스를 수행한다.
평가
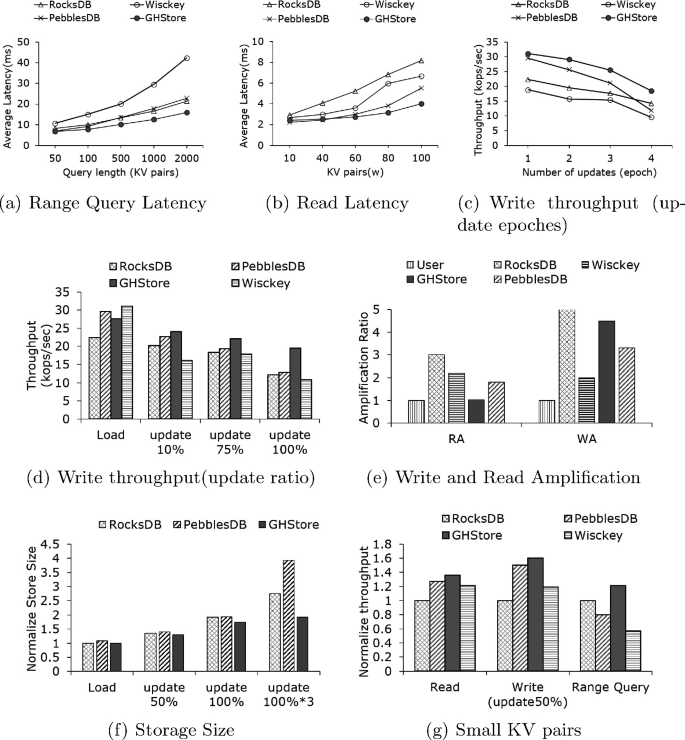
그림의 실험 조건에서는 비교 대상보다 개선된 성능을 보인다. 이 결과의 적용 범위는 논문에서 사용한 워크로드와 설정으로 한정해야 한다.
특히 주목해야 할 읽기 증폭 부분의 경우 40GB에서 300만 KV 쌍을 무작위로 읽는 워크로드에서 측정은 위 그림의 “e”번 항목에서 보는 것과 같이 데이터 레벨별 검색을 회피하기 때문에 가장 낮은 읽기 증폭을 보이는 것을 확인할 수 있다.
공간 증폭은 그림 6(f)에서 비교 대상보다 약 10–20% 작은 저장 공간 사용량으로 나타난다. 블록체인 상태 저장소에 적용하려면 업데이트 분포와 범위 쿼리 빈도가 이 실험과 얼마나 유사한지 확인해야 한다.