LMPTs: Eliminating Storage Bottlenecks
이더리움 클라이언트에서는 상태 저장소의 I/O가 트랜잭션 실행을 지연시킬 수 있다. LMPTs는 이 스토리지 병목을 줄이기 위해 상태 트리를 계층화한 연구다.
MPT(머클 패트리샤 트리)는 상태의 무결성을 검증하는 구조다. 그러나 키 하나에 접근하기 위해 여러 노드를 읽고 갱신해야 하므로 I/O 증폭이 발생할 수 있다.
MPT의 갱신은 경로상의 노드와 해시 갱신으로 이어진다. 디스크 I/O가 완료될 때까지 다음 트랜잭션을 실행하지 못하면 순차 실행 경로의 지연이 커진다. 다만 결정론적 결과가 필요하다는 사실만으로 모든 클라이언트가 반드시 단일 스레드여야 하는 것은 아니다.
논문은 계층화된 머클 패트리샤 트리(LMPT)를 제안하고 실험에서 트랜잭션 실행 처리량을 최대 6배 개선했다고 보고한다. 이 결과는 논문의 실행 엔진과 워크로드에 대한 평가이며, 합의와 네트워크를 포함한 전체 처리량과 구분해야 한다.
핵심은 읽기·쓰기 증폭을 줄이고, 디스크 I/O를 트랜잭션 실행의 주요 경로에서 분리하는 것이다.
문제점
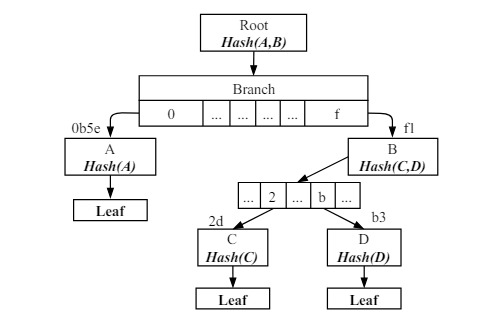
이더리움에서 사용되는 MPT는 각 노드가 자식 노드의 해시를 포함하여 데이터 위조를 방지한다. 트라이의 경로는 한번에 16진수씩 이동하며, 이동 방법은 브랜치 노드에 의해 표현된다.
블록체인 스토리지는 트랜잭션 실행에 대한 주요 성능 병목 지점이다. 따라서 병목 현상 개선은 성능 향상을 위한 필수 관문이라고 볼 수 있다.
MPT에서 주요 성능 병목은 트랜잭션 실행 스레드가 비용이 많이 드는 디스크 I/O 작업을 기다리면서 지연이 발생한다.
실험 환경
저자는 해당 실험을 위해서 AWS EC2.i3.xlarge 인스턴스에서 4 vCPU, 30GB 메모리 및 1TB SSD 저장 공간으로 구성하였고, LMPT 구현을 위해 깃허브에서 제공되는 OpenEthereum v3.1.0버전을 사용하였다. 저장소 성능을 순수하게 비교하기 위해 합의 엔진을 비활성화하고 단일 노드를 포함하는 개인 네트워크에서 실험을 실행했다.
합의와 네트워크의 영향을 줄인 환경에서 실제 트랜잭션 추적을 재생한다. 지불 트랜잭션은 블록당 150개, ERC20 전송은 블록당 20개로 구성해 저장소 동작을 비교한다. 원문 메모의 전체 샘플 개수는 표기가 불명확해 여기서는 생략한다.
LMPTs 디자인
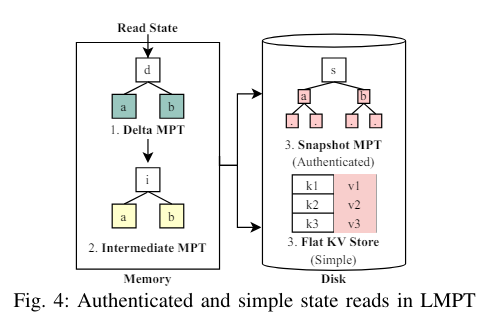
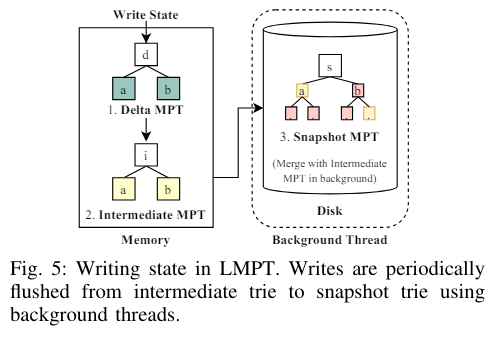
LMPT는 캐시로 작동하는 3가지 서로 다른 MPT로 구성된다. delta, intermediate(중간), snapshot 이라는 3가지 MPT로 구성하여서 상태 트리에 대한 모든 읽기 액세스마다 델타 MPT에서 검색하고, 요청된 데이터가 없을 경우 중간 MPT를 검색하고, 스냅샷 MPT를 확인하도록 설계되었다.
스냅샷 트리와 평면형 키-값 저장소는 디스크에 저장된다. 전체 노드 자체에서도 간단한 읽기는 평면형 키-값 저장소에서 읽을 수 있으며, 이는 값에 액세스할 때, 읽기 증폭을 줄일 수 있다.
최근 변경은 델타 MPT에 반영하고, 중간 MPT와 스냅샷 MPT로 단계적으로 병합한다. 백그라운드 병합을 통해 디스크 작업을 일괄 처리하고 트랜잭션 실행의 주요 경로와 분리한다.
개선
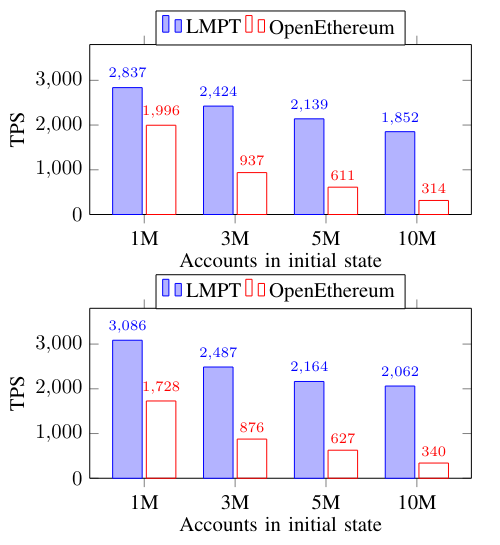
LMPT 기반 OpenEthereum 및 지불 트랜잭션에 대한 TPS는 다음과 같다. 상단 그래프는 이더리움 추적 벤치마크에 해당하고, 하단 그래프는 랜덤 송신자 추적 벤치마크에 해당한다.
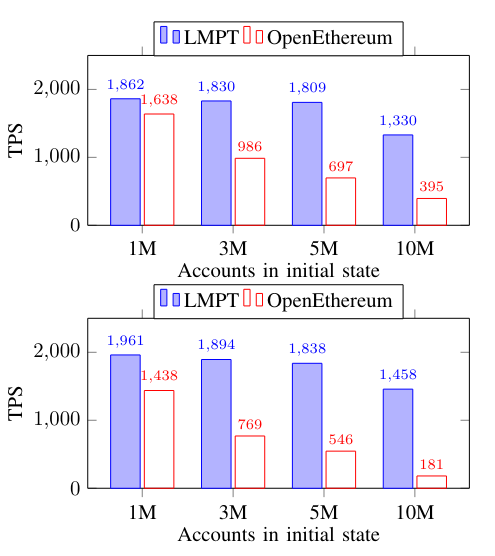
LMPT 기반 ERC20 전송 트랜잭션에 대한 TPS이다. 상단은 이더리움 추적 벤치마크에 해당하고, 하단 그래프는 랜덤 송신자 추적 벤치마크에 해당한다.
결론
LMPT는 세 계층의 MPT와 백그라운드 병합을 통해 트랜잭션 실행 경로의 I/O 부담을 줄인다. 대신 계층별 상태와 병합 과정의 관리가 필요하다.
특히 합의 엔진을 비활성화해 스토리지 효과를 분리한 실험 구성이 참고할 만하다. 논문의 TPS 개선을 실제 네트워크 전체의 처리량 개선과 동일하게 해석해서는 안 된다.